[Paper]nnUNet
U-Net이 2015년에 소개되고 나서 메디컬 이미지 세그멘테이션에서 흔하게 사용되는 벤치마크로 빠르게 발전해왔습니다. 그러나 이러한 방법은 전처리, 학습, 추론 등의 다양한 하이퍼파라미터들의 서치가 필요하게 되어 서로 독립적이지 않고, 순차적으로 종합적인 성능에 영향을 미칩니다. 따라서, ‘no-new-net’이라 불리우는 nnUNet Framework를 해당 논문에서 소개합니다.
Ⅰ. Introduction
해당 프레임워크는 세 가지의 비교적 간단한 U-Net 모델을 기반으로 잔차 연결, 밀집 연결, 주의 매커니즘 등과 같은 최근에 제안된 확장을 생략합니다. 또한, 주어진 이미지 기하학에 맞추어 아키텍처를 자동으로 저장하고 네트워크의 성능에 영향을 미치는 전처리, 학습, 추론 및 후처리 등의 단계를 철저히 정의합니다.
Ⅱ.Method
ⅰ. Network architectures
메디컬 이미지들은 기본적으로 3차원으로 구성되어 2차원, 3차원, cascade U-Net으로 구성된 아키텍처를 고려합니다. 여기서 2D와 3D 유넷은 전체 해상도를 가지고 진행하고, cascade는 낮은 해상도의 세그멘테이션을 생성하고 개선하는 방향으로 진행됩니다. 이러한 방법들은 유넷의 기본적인 골자와 매우 유사하며 대신에 자동화된 학습 파이프라인을 디자인함에 집중했습니다.
오리지널 U-Net의 경우 두 가지 기본적인 컨볼루젼 레이어를 인코더에서 풀링 사이에 사용하고, 디코더에서 컨볼루젼 연산자를 변환하지만 이에 벗어나서 ReLU를 Leaky ReLU로 변환하고, 배치정규화 대신 instance-normalization을 사용합니다.
2D U-Net- 전체 해상도에서 세그멘테이션을 생성.
- 3D에서 2D만 사용하여 부분 최적화로 나타날 수 있음.
3D U-Net- 작은 이미지들은 상관없으나 이미지 크기가 커지면 계산 비용의 문제가 발생함.
Cascade U-Net- 큰 이미지를 다루기 위해 낮은 해상도의 세그멘테이션을 생성하고, 이를 고해상도로 만듦.
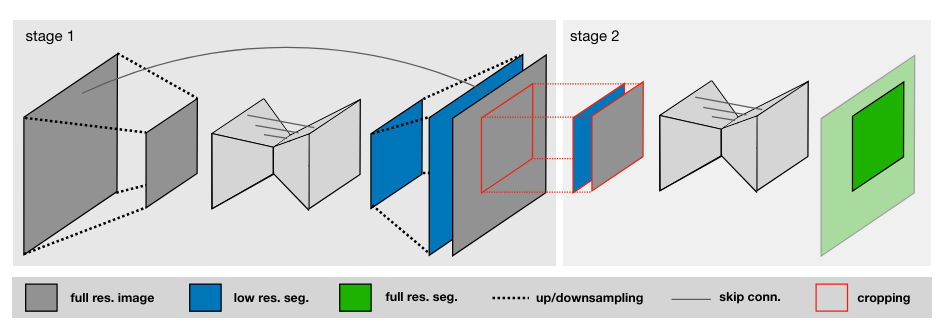 Figure 1 : U-Net Cascade, stage 1 : 다운샘플된 데이터를 처리하여 세그메테이션 맵의 결과를 오리지니널 해상도로 업샘플링함. Stage 2: 이러한 세그멘테이션은 전체 해상도 데이터에 원핫 인코딩으로써 결합됨. 그리고 두번떄 3차원 유넷을 통해 정제됨.
해당 네트워크는 토폴로지의 동적인 적용을 하였습니다. 이미지 크기의 큰 차이 때문에 입력 패치 사이즈와 축 당 풀링 연산의 수가 자동적으로 조정되어 배치 사이즈와 네트워크 수용성 사이의 trade-off 관계를 가지게 됩니다.
Ⅲ. Preprcessing
전처리 작업은 유저의 개입없이 완전히 자동화되었습니다.
- cropping : 0이 아닌 값들의 영역을 크롭함.
- resampling : 데이터셋의 median voxel spacing으로 리샘플링함.
- normalization : CT 스캔의 강도 값을 자동으로 정규화.
\[L_{total} = L_{dice} + L_{CE}\]Ⅳ. Training Procedure
위 공식이 전체적인 손실함수로 다이스 손실함수와 교차 엔트로피 손실함수로 구성됩니다. 따라서, 예측 마스크와 실제 마스크 사이의 손실 함수는 아래와 같이 각 배치 샘플에 대해 다이스 손실을 계산하고 배치 전체의 평균을 구하여 voxel에 대한 Dice 손실을 계산하고, 교차 엔트로피 손실 함수를 통해 계산됩니다.
\[L_{dc} = -\frac{2}{|K|} \sum_{k \in K} \frac{\sum_{i \in I} u^k_i v^k_i}{\sum_{i \in I} u^k_i + \sum_{i \in I} v^k_i}\]여기서 \(u\)는 네트워크의 소프트맥스 출력이고, \(v\)는 실제 분할 마스크의 원-핫 인코딩이며 \(u\)와 \(v\)는 모두 \(I \times K\) 형태를 가지며, \(i \in I\)는 훈련 패치/배치의 픽셀 수, \(k \in K\)는 클래스입니다.
ⅰ. Data Augmentation
제한된 의료 데이터의 양으로 인해 학습시 과적합을 방지하기 위해 다양한 데이터 증강 기법을 도입하였습니다. 이러한 증강 기법들(회전, 스케일링, 탄성 변환, 감마 보정, 미러링 등) 다양한 방법을 통해 학습 중 실시간으로 적용됩니다.
ⅱ. Patch Sampling
네트워크 학습의 안정성을 높이기 위해 배치 샘플 1/3 이상이 foreground를 포함하도록 강제합니다.
Ⅴ. Inference
패치 기반 학습으로 인해 추론도 패치 기반으로 수행됩니다. 네트워크의 정확도가 패치의 경계 쪽에서 감소하기 때문에 패치 간 예측을 집계할 때 중앙에 가까운 voxel에 더 높은 가중치를 부여하고, 패치는 절반의 크기만큼 겹치도록 선택하며 모든 축을 따라 패치를 미러링하여 테스트 시 데이터 증강을 활용합니다.
타일(패치)형 예측과 테스트 시 데이터 증강을 결합하면 각 voxel에 대한 결과는 최대 64개의 예측을 집계하여 얻어지며 학습 시 교차 검증을 통해 얻은 5개의 네트워크를 앙상블하여 모델의 일반화 성능을 견고하게 만듭니다.
ⅰ. Postprocessing
학습 데이터에서 모든 세그멘테이션 클래스에 대한 구성 요소 분석을 수행합니다. 하나의 연결된 구성 요소로 나타나는 클래스의 경우 즉, 하나의 큰 연결된 영역을 데이터셋의 일반적인 속성으로 해석하여 이를 제외한 나머지 작은 영역 개체들을 제거하여 성능을 향상시킵니다.
ⅱ. Ensemble
세그멘테이션 성능과 robustness를 높이기 위해 각 데이터셋에 대해 모든 가능한 조합을 앙상하기 위해 교차 검증에서 가장 높은 성능을 얻은 모델을 자동으로 선택합니다.
Ⅵ. Future Work
이후 새로 발간된 논문에서는 메디컬 세그멘테이션에서 최근 연구들과 비교한 내용을 담은 논문이 발간되었습니다.
해당 논문에서는 새로운 아키텍처에 대한 추구와 기본 UNet보다 우수한 성능에 대한 연구가 계속 되고 있지만 해당 연구들이 흔한 검증 단점에 대해 조사했을때 대다수가 견디지 못했다고 했습니다. CNN 기반과 트랜스포머, 맘바 기반의 접근법을 포함하는 다양한 세그멘테이션 방법들로 부적절한 베이스라인, 불충분한 데이터셋, 계산 리소스 부족과 같은 위험들을 꼼꼼하게 피하기 위해 철저하고 종합적인 벤치마킹을 진행하였습니다.
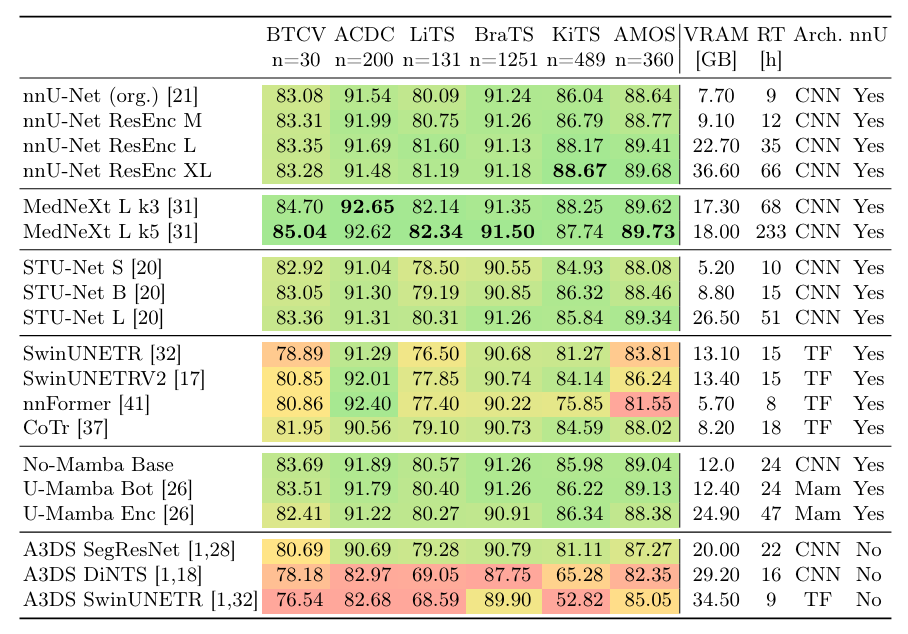 Figure 2 : Benchmark results
결론적으로는 다른 트랜스포머 기반이나 맘바 기반 CNN 기반의 다른 모델과 비교하였고, MedNeXt가 성능은 좋았으나 상당한 학습 시간이 걸리는 걸 고려했을때 nnUNet이 아직도 SOTA의 영역에 있다고 주장하였습니다.
Ⅶ. REFERENCES
- 2018, “nnU-Net: Self-adapting Framework for U-Net-Based Medical Image Segmentation”
- nnU-Net Framework Github
- 2024, “nnU-Net Revisited: A Call for Rigorous Validation in 3D Medical Image Segmentation”