[Paper]Milestones of CNNs
ILSVRC(ImageNet Large Scale Visual Recognition Challenge)를 통해 이미지 인식 분야의 유명한 대회로 2017년을 마지막으로 공식적인 대회를 마무리했지만, 그동안의 성과들은 컴퓨터 비전분야의 핵심적인 연구 기반이 되었다고 합니다. 따라서, 해당 대회 사이의 논문들을 간략하게 소개해보려고합니다.
Figure 1 : ILSVRC(ImageNet Large Scale Visual Recognition Challenge)
Ⅰ. Alexnet
해당 논문의 성공을 통해 딥러닝의 부흥을 이끌게 되었으며 대규모 데이터와 GPU를 사용한 효율적인 병렬 학습을 통해 높은 성능을 입증하였고, 딥러닝의 표준이 되었습니다.
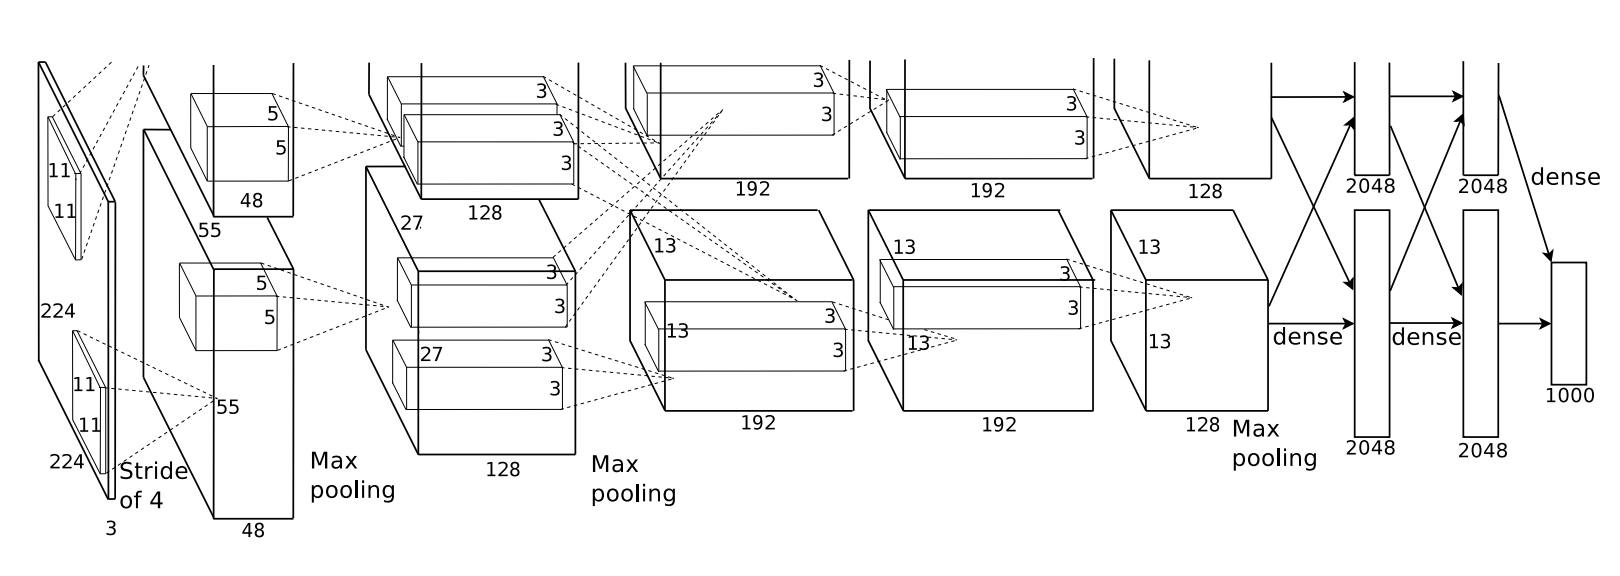 Figure 2 : An illustration of Alexnet, 두 GPU 간의 책임을 나타내며 상단에 GPU와 하단의 GPU들은 특정 레이어에서만 통신함.
ⅰ. Nonlinearity
기존에는 tanh를 써왔으나 해당 논문에서 언급한 ReLU가 tanh보다 학습이 더 빠름을 증명하였습니다.
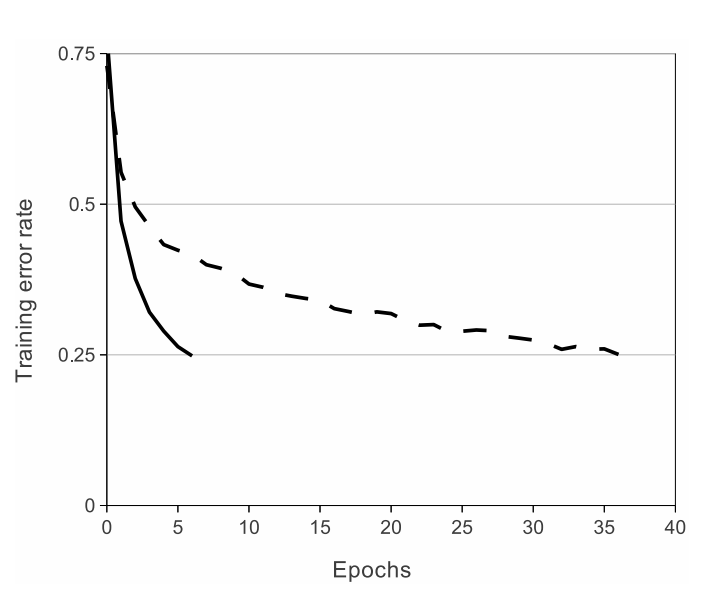 Figure 3 : 점선(tanh) 보다 실선(ReLU)이 6배 가량 빠름.
ReLU를 사용하여 학습 속도를 증가시키는 것이 해당 데이터셋에 대한 빠른 과적합을 야기할 수 있지만 여기에서는 학습속도를 증가시키는 효과와는 다르다는 문제라고 명시하여 빠른 학습은 큰 데이터셋에서 큰 모델의 학습 성능에 훌륭한 영향을 미칠것이라고 말했습니다.
ⅱ. Multiple GPUs
해당 모델은 한개의 GTX 580 GPU는 3GB를 가지고, 1,2 million의 데이터를 학습하는데 제한이 있어 Figure 2 그림과 같이 두개의 GPU로 네트워크를 분산시킵니다.
GPU들은 해당 GPU에 올라온 데이터만을 사용하다가 특정 레이어에서 GPU들 끼리 통신하게 됩니다. 즉, GPU 끼리 병렬화하여 데이터를 학습하다 특정 레이어에서만 서로 특징을 공유(각 GPU에 올라온 데이터들을 모두 사용)한다는 의미로 이러한 GPU 병렬화 기법은 cross-validation에는 문제가 있지만 방대한 학습 데이터를 학습하는게 가능하다고합니다.
ⅲ. Local response normalization(LRN)
해당 모델에서 일반화를 위해 지역 정규화 스키마인 LRN을 적용하였습니다.
\[b_{i}(x,y) = a_{i}(x,y) \left( k + \alpha \sum_{j=\max(0,i-n/2)}^{\min(N-1,i+n/2)} (a_{j}(x,y))^2 \right)^{\beta}\]- \(b_{i}(x,y)\): Output at position \((x,y)\) in the \(i\)-th kernel map after normalization.
- \(a_{i}(x,y)\): Input at position \((x,y)\) in the \(i\)-th kernel map before normalization.
- \(N\): Total number of kernel maps (or filters) in the layer.
- \(k, n, \alpha, \beta\): Hyperparameters determined through validation:
- \(k\): Constant term.
- \(n\): Number of adjacent kernel maps considered.
- \(\alpha\): Scaling parameter.
- \(\beta\): Bias term.
이러한 LRN의 적용은 측면억제(lateral inhibition)와 유사하게 정규화(brightness normalization라고도 함)를 나타내어 실제 신경망 출력물들 사이에서 큰 활동에 대해 경쟁을 생성합니다. 이를 통해 1.4% 1.2% 에러 감소를 나타내었다고 합니다. 이후에는 이러한 방법보다 batch normalization 기법을 활용하게 되었습니다.
ⅳ. Overlapping Pooling
일반적인 인접 풀링 유닛을 통해 요약된 이웃들을 overlap(겹치게)하지 않았습니다. 더 상세하게 우리는 일반적으로 학습 동안 overlapping한 풀링 모델이 약간 더 과적합 되기 어렵다고 합니다. 해당 논문에서도 Non-overlapping과 Overlapping의 결과를 비교하였을때 0.3% 오류율이 낮아지는 결과가 있었다고 합니다.
ⅴ. Data augmentation
또한, 해당 논문에서 과적합 방지를 위해 이미지 변환과 반전이나 RGB 값을 변환시키는 방법 증강기법과 Dropout 등을 통해 오류율과 과적합을 낮출 수 있었다고 합니다.
Ⅱ. VGGNet
이전 포스팅인 Resnet에서 언급한 것과 같이 VGGNet은 네트워크의 깊이를 늘리는게 성능 향상에 중요하다는 것을 보여주는 논문으로 CNN 네트워크 깊이의 영향을 조사했습니다.
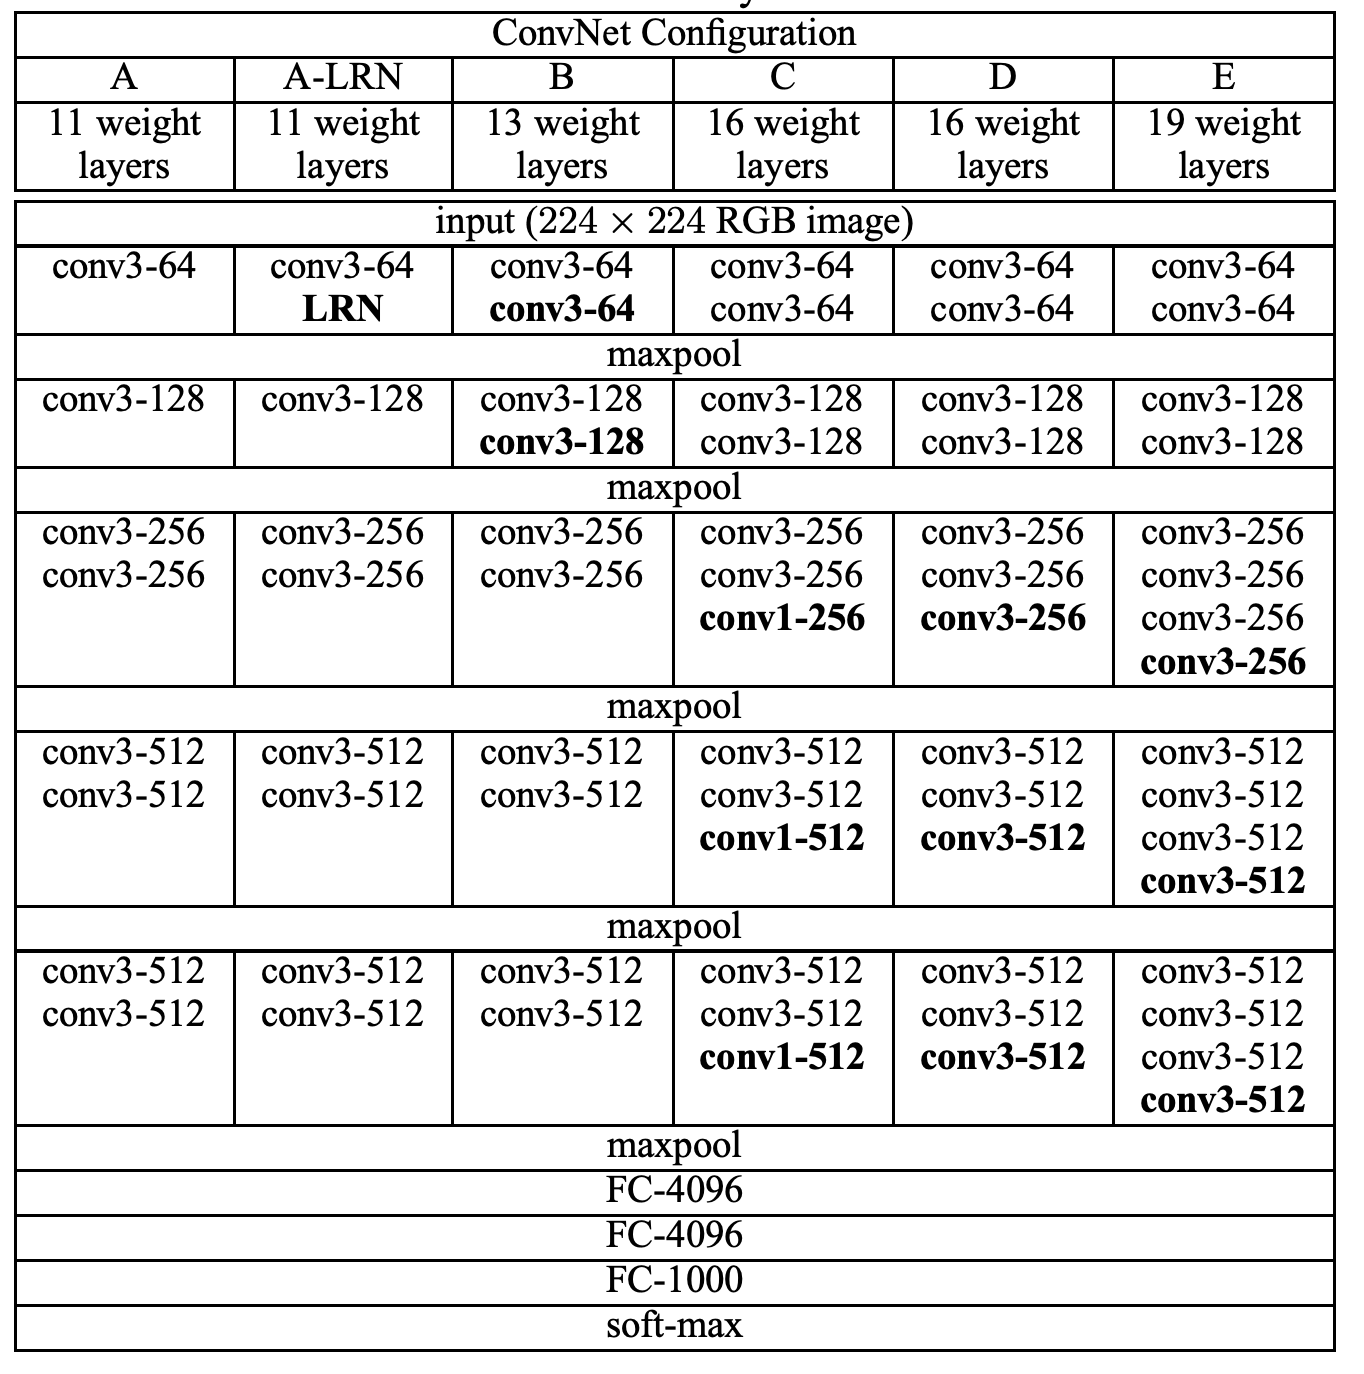 Figure 4 : 왼쪽에서 오른쪽으로 갈 수록 깊이가 깊어짐. D가 VGG16이고, E가 VGG19임.
큰 필터(11x11, 7x7) 대신 3x3 필터를 사용하고 스트라이드(stride)를 1로 적용합니다. 이렇게 작은 크기의 필터를 쌓으면 큰 필터들의 효과를 얻으며 부가적인 장점들이 존재합니다.
첫번째로 작은 필터를 여러개 쌓으며 비선형 활성화함수를 적용된 신경망(rectification layer)을 포함하여 결정함수가 더 복잡해지고 분별력(discriminative)이 향상됩니다. 둘째로 파라미터 수의 감소가 이루어져 큰 필터수보다 81%나 감소하게 됩니다. 이는 7x7을 3x3 필터로 분해를 강제함으로써 7x7의 인상적인 규제화로 보여집니다.(\(3^2C^2*3 27C^2; 7^2C^2 49C^2 = 49/27 = 1.81...%\))
Ⅲ. GoogleLenet
해당 모델도 VGGNet과 유사하게 신경망의 깊이도 늘리되 병렬 컨볼루젼을 사용하여 너비도 동시에 확장하여 성능을 높이는 접근법을 보여주었습니다. 여기서 병렬 컨볼루젼을 inception 모듈을 도입하여 가능하게 했습니다.
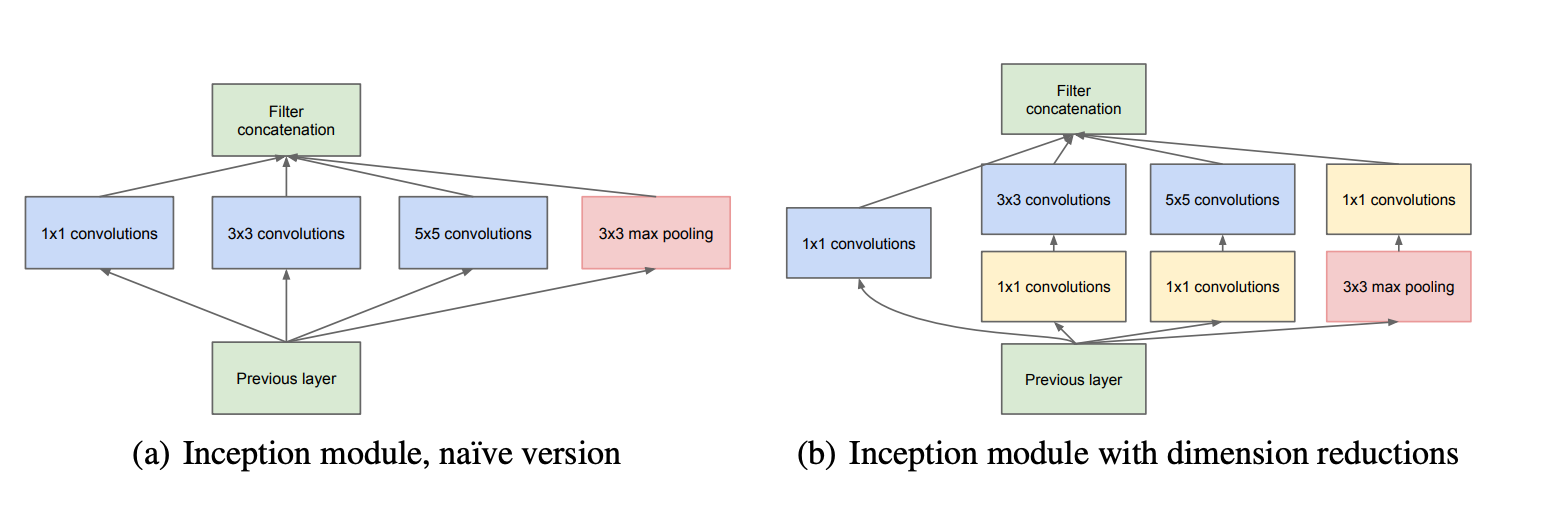 Figure 5 : : Inception module
일반적으로 성능을 늘리기 쉬운 방법은 크기를 늘리는 것이지만 이에 큰 단점이 두가지 따라오게 됩니다. 큰 사이즈는 많은 파라미터를 뜻하여 과적합되기 쉽고, 또 하나는 네트워크 사이즈가 극적으로 커져 계산 리소스가 증가된다는 단점이 있습니다. 그리고 전통적인 ConvNet은 초기 가중치의 무작위성과 입력 이미지의 지역적인 연결만 되는 희소한 연결성을 특정 차원에서 사용한다는 특징이 있습니다. 이를 더 좋게 최적화된 병렬 계산으로 하는 방법이 해당 논문에서 소개된 Inception 모듈입니다.
이러한 Inception 아키텍처의 주된 아이디어는 얼마나 최적화한 지역 희소 구조를 ConvNet에서 찾는 것인가 입니다. ConvNet은 일반적으로 Dense 구조로 계산할 수 있으며, 앞서 말한 지역 희소 구조를 찾기위해 다양한 필터 크기를 병렬적으로 사용하여 최적화합니다.
해당 모듈은 translation 불변성이 해당 네트워크에서 컨볼루젼 빌딩 블록으로 지어져 마지막 레이어에서 여러 층(layer)간의 상관관계를 분석하고 높은 상관성을 가지는 유닛들을 같은 그룹으로 클러스터하는 방법을 제안하였습니다. 이러한 클러스터들은 다음 층의 유닛을 형성하고, 이전 레이어에서 유닛들을 연결해 다음층에서 더 큰 특징을 학습할 수 있도록 연결됩니다.
이렇게 많은 클러스터들을 단일 영역으로 모으다보면 1x1 컨볼루젼 레이어를 통해 집중시켜 특징을 추출해 다음 층에서 커버될 것입니다. 이러한 인셉션 모듈을 서로 겹쳐져 쌓으면 다양하게 바운드되어 높게 추상화된 특징은 높은 층에서 수집되고 공간적인 집중이 감소되도록 예상된다고 하였습니다.
위 모듈의 가장 큰 문제는 적어도 이 단순한 형태에서는 5x5 컨볼루젼은 엄청나게 비쌀 수 있다는 문제가 존재합니다. 이러한 문제는 차원 축소와 투영을 적용해 임베딩의 성공을 기반으로 한것으로 낮은 차원의 임베딩 조차도 비교적 큰 이미지 패치에 대한 많은 정보를 포함할 수 있음을 의미합니다.
즉, 이처럼 한 레이어에 여러가지 다양한 크기의 필터를 사용하여 서로 다른 스케일의 특징을 동시에 추출하고 결합하는 점과 1x1 필터로 차원 축소 및 비선형성 추가에 사용되어 투영역할을 하고 계산 효율성을 높이게 됩니다.
Ⅳ. ResNet
이전 포스팅 참고 하겠습니다.
Ⅴ. Densenet
Densenet(Densely Connected Convolutional Networks)은 아래 그림과 같이 각 레이어가 모든 이전 레이어들과 직접 연결되는 구조의 신경망입니다.
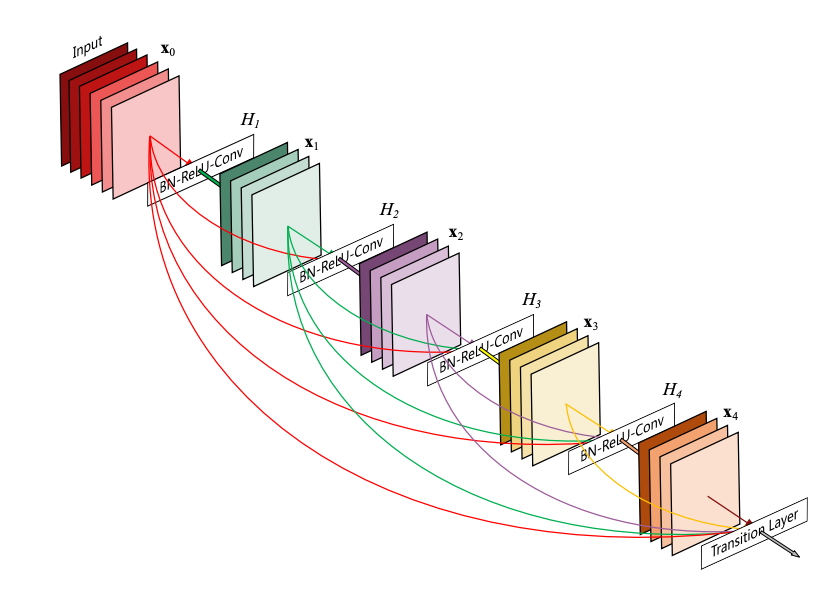 Figure 6 : A 5-layer dense block with a growth rate of k = 4.Each layer takes all preceding feature-maps as input.
기존의 전통적인 컨볼루젼 네트워크에서는 레이어가 차례대로 연결되지만, 해당 아키텍쳐에서는 각 레이어가 이전 레이어들의 출력을 입력으로 받아들여 L개의 레이어가 존재하면 각 레이어는 L개가 아닌 L(L+1)/2의 연결을 가지게 됩니다. 이러한 구조는 기울기가 역전파될 때 사라지지 않고 전달되고, 이를 통해 네트워크가 깊어질수록 발생하는 기울기 소실 문제를 완화하고 특징 전달을 강화하며 특징 재사용을 격려해 필요 이상의 파라미터를 사용하지 않아 충분한 파라미터의 수를 줄입니다. 이러한 장점은 더 효율적인 학습을 가능하게 하며, 과적합을 방지할 수 있습니다.
즉, DenseNet은 기울기 소실 문제를 해결에 기여하고, 특징 재사용을 통해 효율적인 학습을 가능하게 하며, 파라미터를 절약하는 구조입니다.
Ⅵ. EfficientNet
해당 논문에서는 모델의 확장(Scaling)과 정체성을 네트워크의 깊이(depth), 넓이(width), 해상도(resolution)의 밸런스를 갖추어 더 좋은 성능을 이끄는 연구를 진행하였습니다. 이러한 결과에 기반하여 새로운 스케일링 방법으로 Compound Model Scaling이라는 새로운 방법을 제안하여 네트워크의 성능을 흭일적인 스케일로 모든 깊이, 넓이, 해상도 차원에서 효율적으로 향상시키는 방법을 설명했습니다.
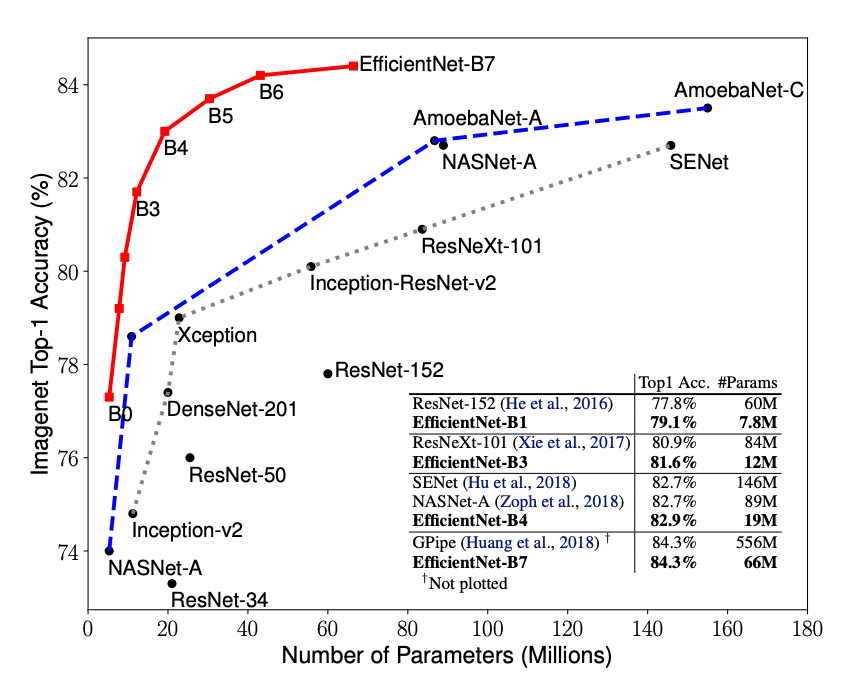 Figure 7 : Model Size vs. ImageNet Accuracy, 단일 채널 스케일링 업보다 $
이러한 방법은 모델의 설계와 최적화 방벱어 새로운 기준을 제시하였고, 동시에 균형있게 확장하는 방법과 최적의 네트워크 구조를 자동으로 검색하는 방법을 설명했습니다. 초기에 더 큰 이미지에서 많은 픽셀을 포함하는 높은 해상도 이미지에서 네트워크의 깊이를 증가시켰더니 큰 수용 영역은 유사한 특징을 수집하는데 도움이 되었으며 연관되어 네트워크의 넓이도 해상도가 높을때 증가시켰더니 이미지에서 fine-grained(상세한; 다른말로 coarse-grained로 덜 섬세함을 의미) 패턴을 더 잘 수집할 수 있었습니다. 이러한 초기의 제안은 다른 스케일링 차원이 간단한 단일 차원 스케일링보다 밸런스와 조죅화할 필요가 있다고 제안하였습니다.
다시말해 일반적인 스케일링의 방법으로 깊이, 넓이, 해상도 중 하나만을 스케일링하면 일시적으로 정확도가 향상되지만, 모델이 커지면서 성능이 약화될 수 있음을 확인하고 경험적으로 각각의 스케일링 요소들은 독립적인 차원이 아니며 균형 있게 스케일링할 때 성능이 더 잘 향상된다는 것을 발견하였습니다. 즉, 하나의 차원만 확장하는 대신 모든 차원을 동시에 조직화해 균형을 맞추며 확장해야한다는 뜻입니다.
ⅰ. Compound Scaling
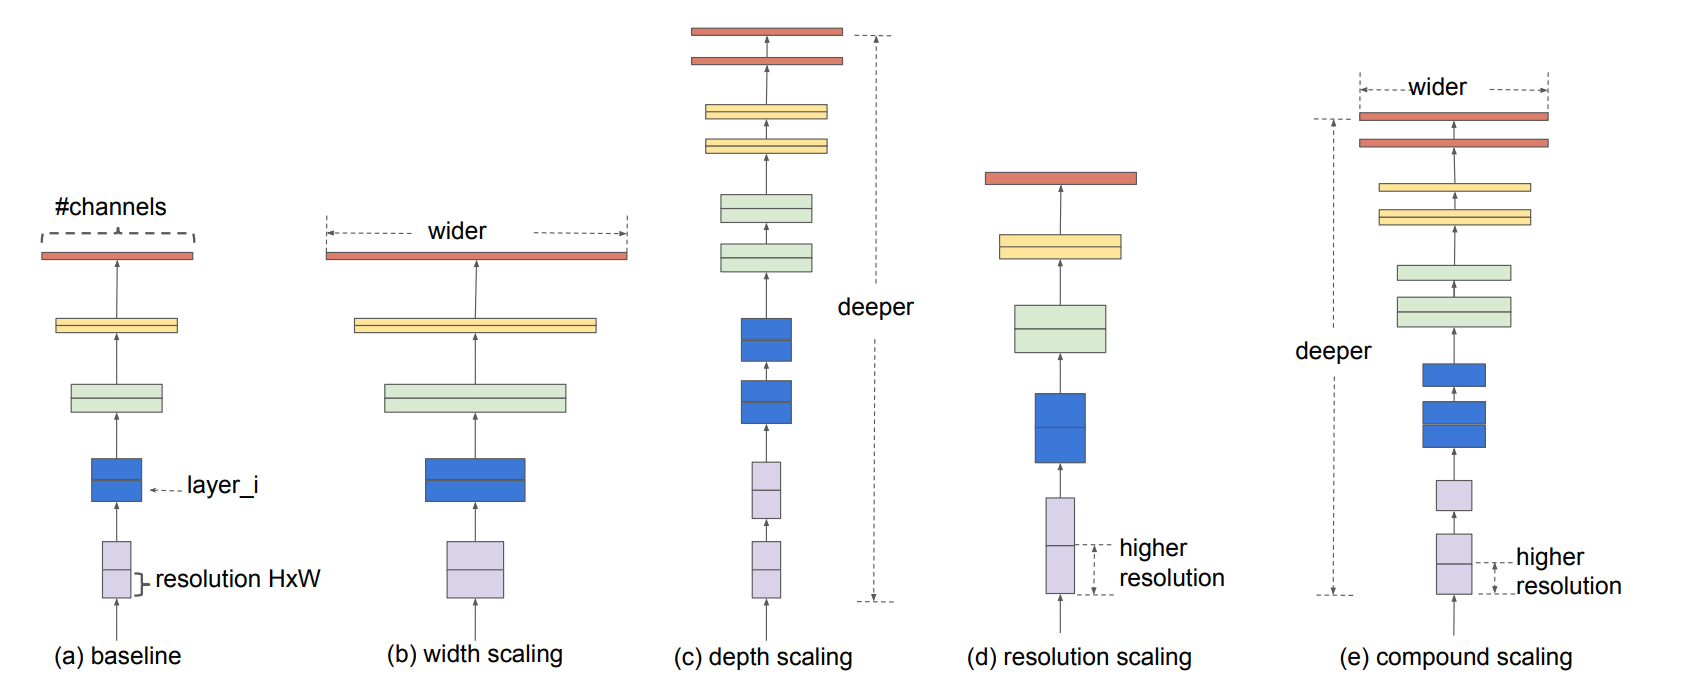 Figure 8 : e 제안된 compound scaling method로 흭읠화된 스케일로 세 차원을 고정된 비율로 스케일링함.
해당 방법론은 Compound coefficient(φ)를 사용하여 깊이, 넓이, 해상도를 동시에 스케일링하는 방법입니다. α(depth), β(width), γ(resolution)라는 세 가지 변수를 사용하여 작은 그리드 탐색(grid search)을 통해 최적의 비율을 찾고, α⋅β²⋅γ² = 2라는 제약을 두어 FLOPs(부동소수점 연산량)의 비율을 정해 네트워크 성능과 효율성을 극대화하는 모델을 설계할 수 있습니다.
결론적으로, 이 논문은 네트워크의 스케일링을 모든 차원의 밸런스를 잡으면서 균형 있게 진행할 때 성능이 더 좋아진다는 점을 실험적으로 입증했으며, Compound Scaling이라는 효율적인 방법을 통해 모델 설계와 최적화에 새로운 방향을 제시합니다.
Ⅶ. References.
- Alex and Hinton at el, “ImageNet Classification with Deep Convolutional Neural Networks”, 2017
- Simonyan at el, “VERY DEEP CONVOLUTIONAL NETWORKS FOR LARGE-SCALE IMAGE RECOGNITION”, 2015
- Google Inc, “Going deeper with convolutions”, 2014
- Haung at el,”Densely Connected Convolutional Networks”, 2018
- M. Tan at el,’EfficientNet: Rethinking Model Scaling for Convolutional Neural Networks’, 2020