[Paper]Image Segmentation Using Deep Learning: A Survey
이미지 분할은 semantic 과 instance로 분할하는 것으로 형식화가 가능합니다. 의미적 분할은 이미지 픽셀에 대한 객체 카테고리 집합으로 픽셀 수준 레이블링을 진행하는 것이고 인스턴스 분할은 각 객체를 감지하고 구분하는 작업을 추가하여 의미적 분할의 범위를 확장하는 형태로 해당 논문에서는 2019년 까지의 딥러닝 기반 세그멘테이션 방법을 소개합니다.
Ⅰ. Fully convolutional networks
해당 네트워크는 컨볼루젼 레이어만 포함하여 풍부한 크기의 이미지를 받아 같은 크기의 세그멘테이션 맵으로 처리합니다.
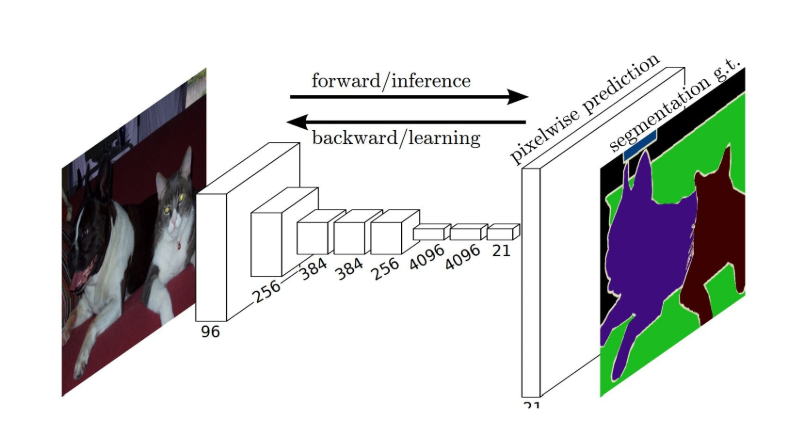 Figure 1 : fully convolution network
모델의 마지막 층으로부터 특징맵들을 skip-connection을 사용하는 것을 통해 업샘플링되고, 앞선 레이어의 특징맵과 함께 융합하여 모델이 의미론적인 정보를 결합하게 합니다. 다음과 같이 parseNet로 불리우는 모델은 FCN의 글로벌 컨텍스트 정보를 무시하여 문제를 다룹니다.
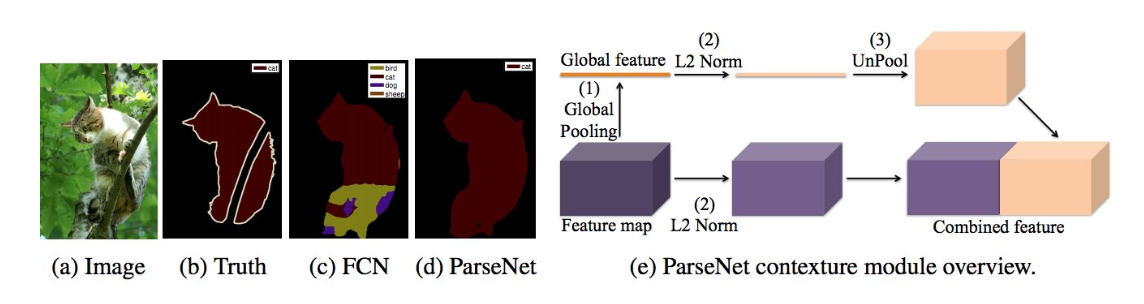 Figure 2 : ParseNet
해당 모델은 이미지 세그멘테이션에서 중요한 마일스톤으로 고려되며 엔드투엔드의 가변적인 크기의 이미지에서 semantic 세그멘테이션을 위해 학습된 네트워크의 설명으로 실제 추론에 적합할만큼 빠른 추론이 안되고, 3D 이미지로 변환이 쉽게 되지 않는 다는 제한이 존재합니다.
Ⅱ. Convolutional models with graphical models
FCN은 잠재적으로 유용한 scene-level semantci context를 무시합니다. 따라서, 더 많은 컨텍스트를 통합하기위해 확률적 그래프 모델의 접근법(조건부 랜덤 필드, 마코브 랜덤 필드 등)을 포함시킵니다.
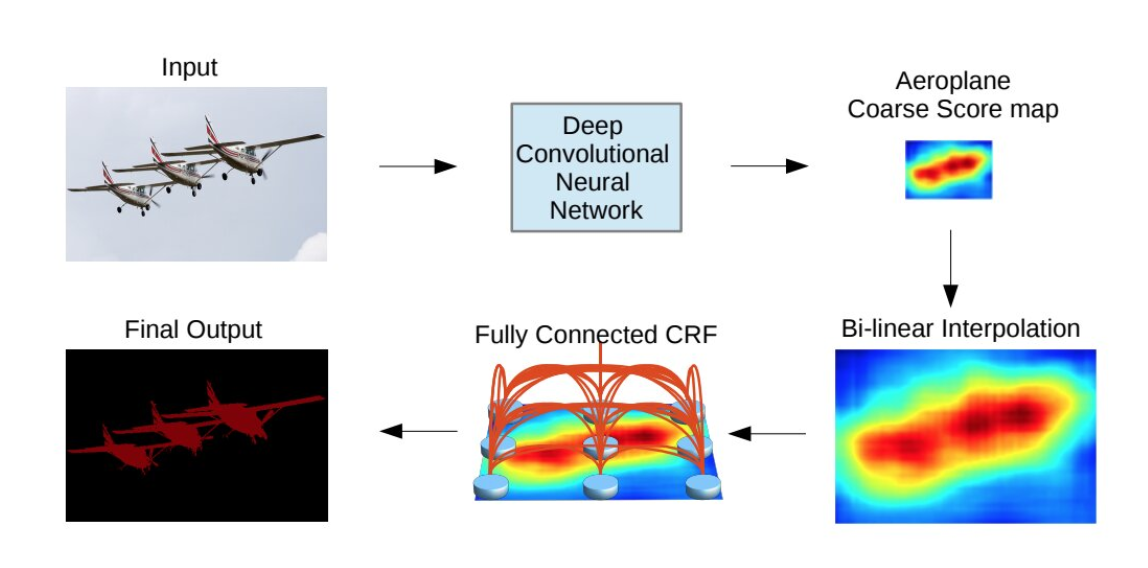 Figure 3 : CNN+CRF model,
위와 같이 CNN과 CRF가 결합하여 FCN에서 충분히 지역화 되지 않는 속성을 해결하고자 CRF를 결합하였습니다.
Ⅲ. Encoder-decoder based models
대부분의 딥러닝 기반 이미지 세그멘테이션 작업은 encoder-decoder 형태의 모델을 사용하고, 다음과 같이 적용에 따라 두 가지 구분으로 나눈다고 합니다. 이러한 방식은 잠재 표현 입력의 의미적인 정보를 수집할 수 있어 유용합니다.
ⅰ. Encoder-Decoder Models for General Segmentation
디컨볼루젼에 기반한 초기의 논문은 VGG 16-layer 네트워크에서 채택된 컨볼루젼 레이어를 사용하여 인코더와 특징 벡터를 입력으로 받아 픽셀 단위의 클래스 확률 지도를 생성하는 디컨볼루젼 네트워크로 구성됩니다. 여기서 디컨벌로젼 네트워크는 디컨볼루젼과 언풀링 레이어로 구성되며, 픽셀 단위의 클래스 레이블을 식별하고 세그멘테이션 마스크를 예측하게 됩니다.
해당 네트워크는 PASCAL VOC 2012 데이터셋에서 72.5%로 가장 좋은 성능을 보인 방법이라고 합니다.
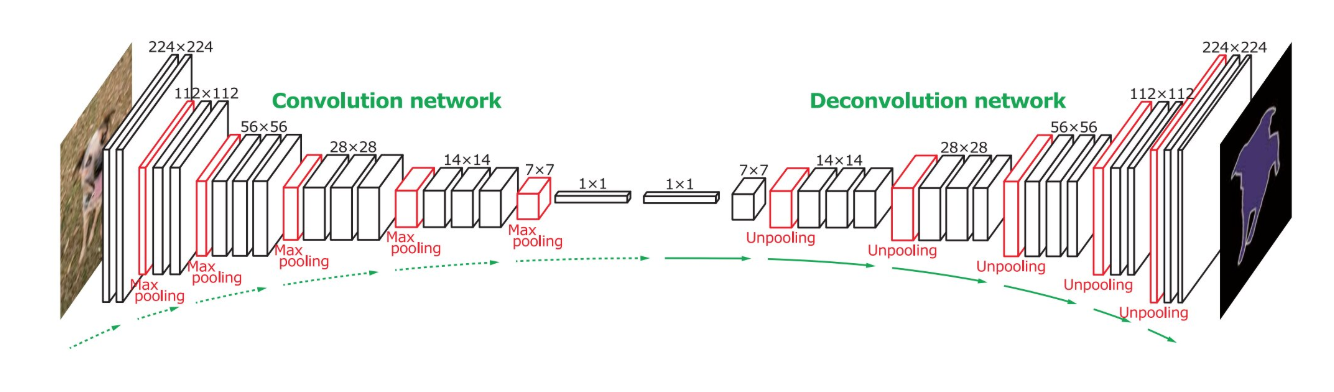 Figure 4 : Deconvolutional semantic segmentation.
다른 아키텍처로는 위와 유사하지만 디코더에서 입력 특징 맵을 업샘플링하는 방식을 가지는 SegNet이 존재합니다. 이는 인코더에서 계산된 풀링 인덱스를 사용하여 비선형 업샘플링을 수행하여 업샘플링 학습의 필요성을 제거하여 학습 파라미터의 수가 적다는 특징이 존재합니다.
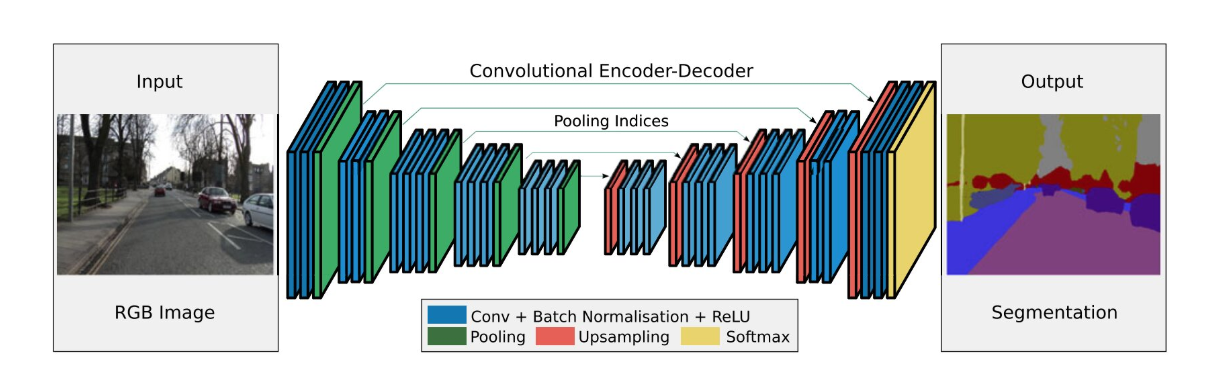 Figure 5 : Overview of SegNet
또 다른 모델은 HRNet으로 DeConvNet, SegNet, U-Net 및 V-Net에서 수행한 것처럼 고해상도 표현을 복원하는 것 외에도 인코딩 과정에서 고해상도 표현을 유지하는데, 이는 고해상도에서 저해상도로의 합성곱 스트림을 병렬로 연결하여 해상도 간의 반복적인 정보 교환을 통해 이루어집니다.
간단히 말해 각 해상도의 stream을 유지하며 정보를 교환하는 형식입니다. 해당 분야의 많은 연구들이 HRNet을 기반으로 self-attention과 같은 context 모델에 많이 활용합니다.
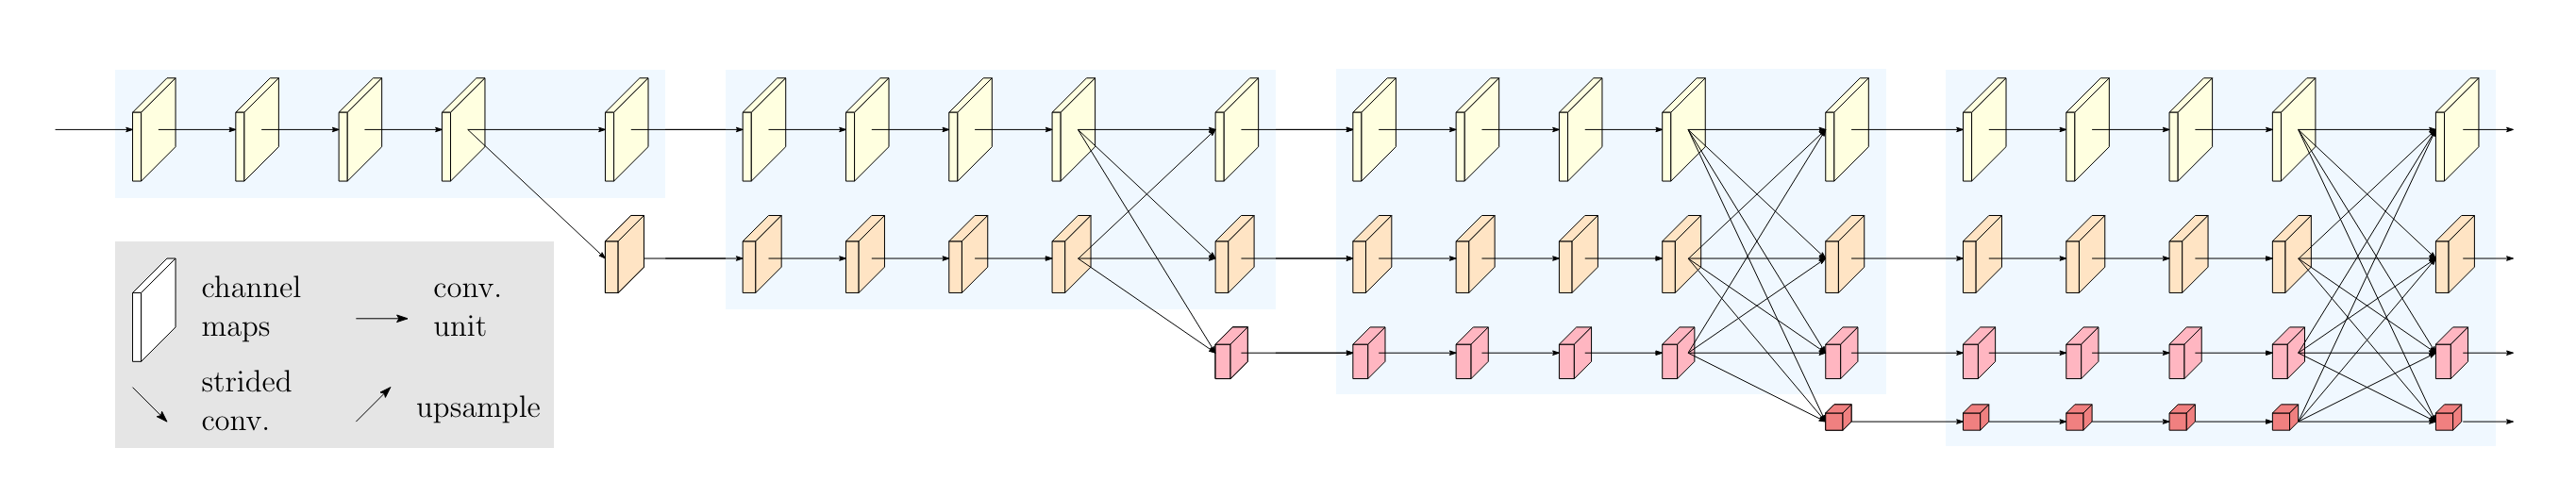 Figure 6 : Illustrating the HRNet architecture.s
이러한 인코더-디코더 기반 모델들은 인코딩 과정에서 고해상도 표현의 손실로 인해 이미지의 상세한 정보가 손실되는 문제를 안고 있으며 최근의 아키텍쳐에서 이러한 문제들을 해결해 나아가고 있습니다.
ⅱ. Medical and Biomedical Image Segmentation
메디컬 이미지 세그멘테이션을 위해 개발된 U-Net과 V-Net은 유명한 모델로 의료 분야를 넘어 다른 분야에서도 많이 사용되고 있습니다.
U-Net은 생물학에서 현미경 이미지를 분할하기 위해 제안한 모델로, 데이터 증강을 사용하여 적은 데이터로 부터 효과적으로 학습을 진행하였으며 context를 수집하기 위한 수축 경로와 정확한 위치 지정이 가능한 대칭적 확장 경로로 이루어져 U자 모양의 아키텍처로 구성됩니다.
또 다른 V-Net은 3D 의료 이미지 세그멘테이션을 위해 제안된 모델로 Dice 계수를 기반으로 새로운 목적 함수를 도입하여 foregorund와 background의 voxel 수가 불균형한 상황을 처리할 수 있도록 하였습니다. 관련된 연구로 Progressive Dense V-Net(PDV-Net)이나 3D-CNN 인코더 등이 진행되고 있다고 합니다.
Ⅳ. Multi-scale and pyramid network based models
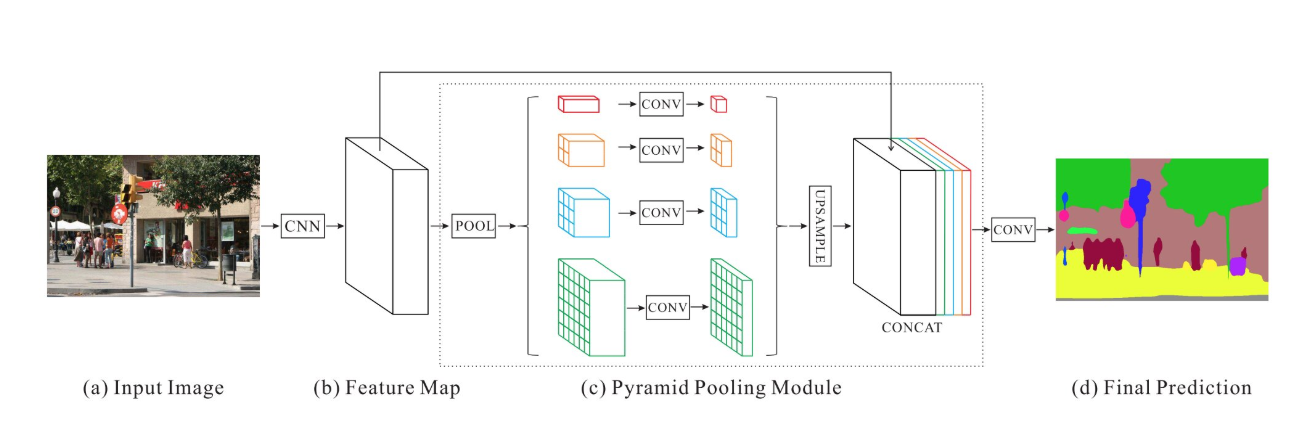 Figure 7 : The PSPN architecture.
다중 스케일 분석은 이미지 분야에서 오래된 아이디어로 다양한 아키텍처에 적용되어 왔습니다. 가장 유명한 모델로 Feature Pytamid Network(FPN)으로 다중 스케일 피라미드 계층 구조를 사용하여 특징 피라미드를 구성합니다. CNN이 특징 맵을 처리하고 피라미드 형태의 풀링 모듈이 다른 부분 영역 표현을 종합합니다. 이후 병합된 특징 맵은 컨볼루젼을 통해 얻어진 특징 표현을 가지고 픽셀 단위의 예측 마스크에 사용됩니다.
이후 잔차 네트워크를 특징 추출기로 사용하여 입력 이미지에서 다양한 패턴을 추출해 피라미드 풀링 모듈로 전달되어 다른 스케일의 패턴을 구분하는 Pyramid Scene Parsing Network(PSPN)도 게재되었으며 이 외에도 다중 스케일 분석을 세그멘테이션에 사용하는 다양한 모델들이 존재했습니다.
Ⅴ. R-CNN based models (for instance segmentation)
R-CNN(Region-based Convolutional Network)기반의 모델들은 객체 탐지에서 큰 성공을 거두었습니다. 특히, 아래와 같은 Fast R-CNN은 영역 제안 네트워크(Region Proposal Network, RPN)를 사용하여 경계 상자 후보를 제안하여 RoI를 추출하고, 이러한 제안으로부터 특징을 계산하여 경계 상자 좌표와 객체의 클래스를 추론합니다. 즉, 객체 탐지와 의미론적 세그멘테이션을 동시에 수행하는 작업입니다.
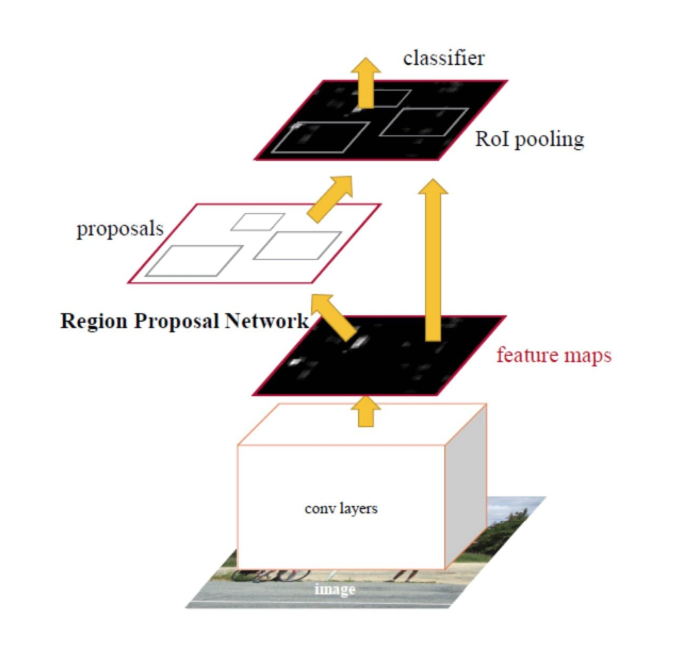 Figure 8 : Faster R-CNN architecture.
이러한 모델의 확장으로 객체 인스턴스 세그멘테이션을 위한 Mask R-CNN 모델은 여러 COCO 데이터셋에서 좋은 성능을 보였으며 각 인스턴스에 대한 고품질의 세그멘테이션 마스크를 생성하였습니다. 아래와 같이 경계 상자 좌표를 계산하고, 관련 클래스, 세그멘테이션을 위한 이진 마스크를 차례대로 계산하여 공동으로 학습힙니다.
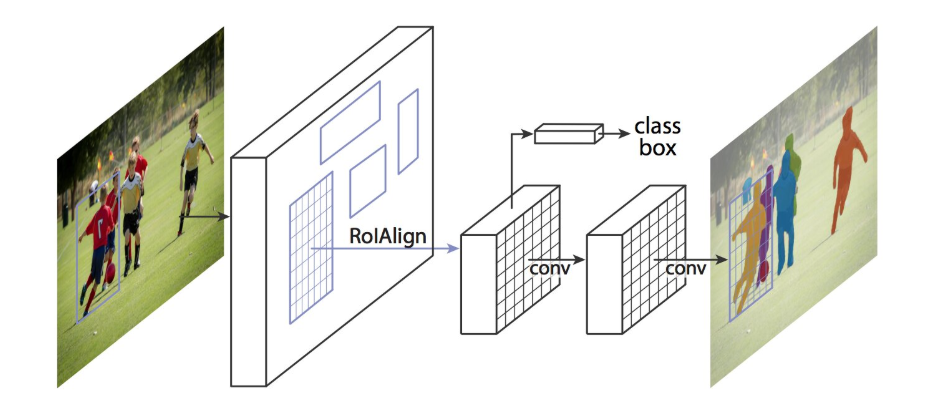 Figure 9 : Mask R-CNN architecture for instance segmentation
그 다음으로 제안된 Path Aggregation Network(PANet)는 위의 두 모델을 기반으로 저층 특징의 전파를 개선하였습니다.
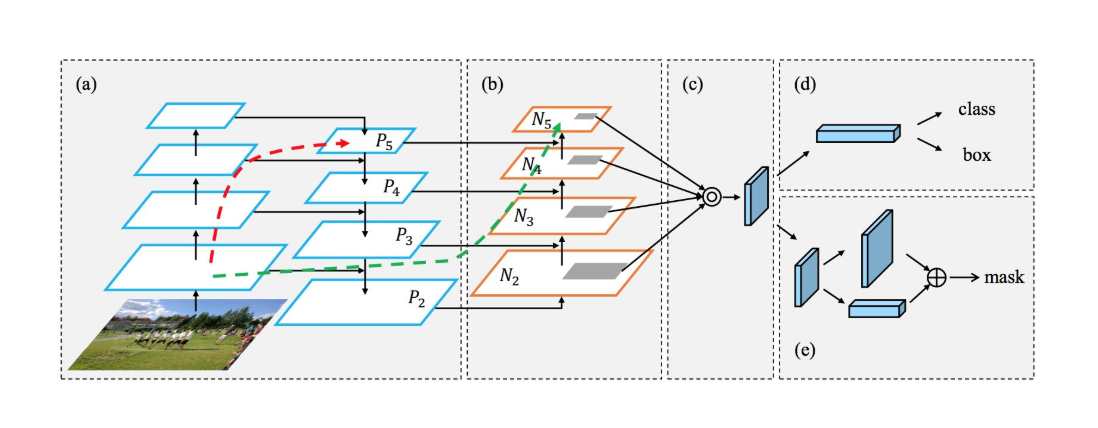 Figure 10 : The Path Aggregation Network, (a) FPN backbone. (b) Bottomup path augmentation. (c) Adaptive feature pooling. (d) Box branch. (e) Fully-connected fusion
또 다른 방법으로 소개된 다중 작업 네트워크는 아래와 같이 각각 인스턴스를 구분하고, 마스크를 추정하며 객체를 분류하는 방법이 존재했습니다. 해당 네트워크는 Faster R-CNN을 기반으로 세그멘테이션 및 방향 특징을 포함한 모델로 상자 탐지, 의미론적 스게멘테이션, 방향 예측 세 가지를 출력합니다.
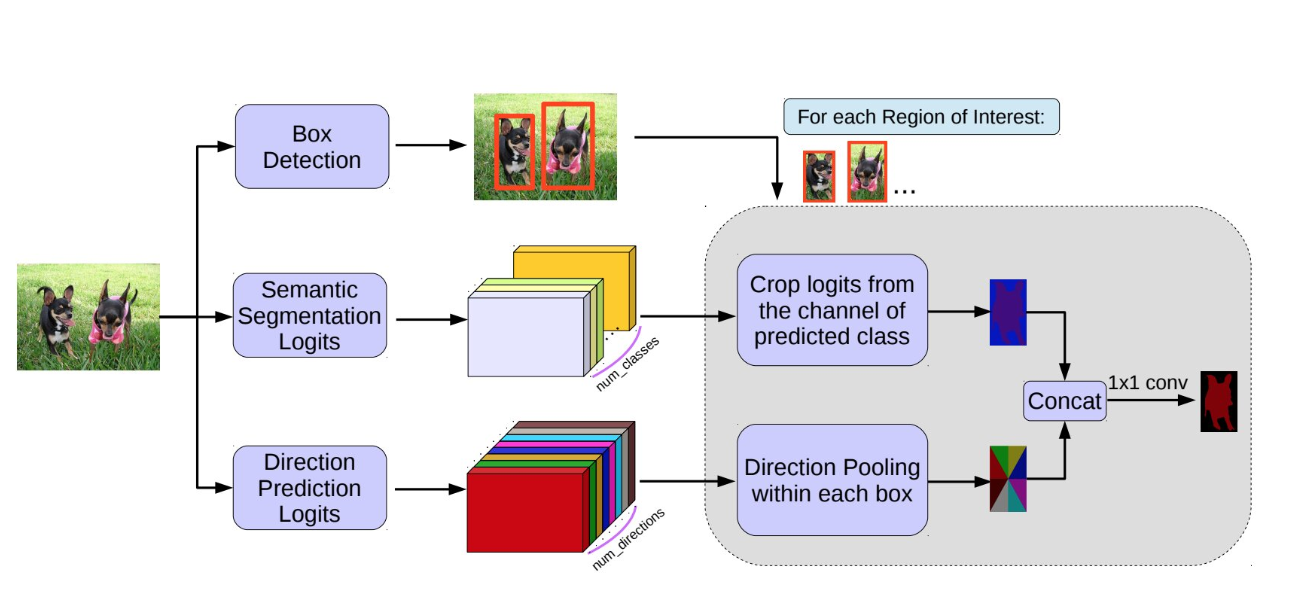 Figure 11 : The MaskLab model.
이 외에도 TensorMask, R-FCN, DeepMask 라는 R-CNN을 기반으로 하는 모델들도 개발되고 있습니다.
Ⅵ. Dilated convolutional models and DeepLab family
Dilated(atrous) 컨볼루젼은 dilation rate라는 매개변수를 도입합니다. 신호 \(x(i)\)의 dilated convolution은 \(y_i = \sum_{k=1}^K x[i + rk]w[k]\)로 정의되며, 여기서 \(r\)은 커널 \(w\)의 가중치 사이의 간격을 정의하는 dilation rate입니다.
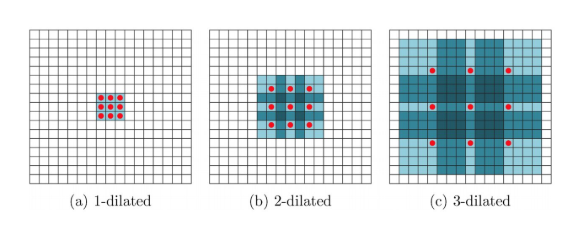 Figure 12 : Dilated convolution. A 3 × 3 kernel at different dilation rates.
예를 들어, dilation rate가 2인 3 × 3 커널은 5 × 5 커널과 동일한 크기의 수용 영역을 가지지만, 단 9개의 매개변수만 사용하여 계산 비용의 증가 없이 수용 영역을 확장합니다. 해당 방법은 실시간 세그멘테이션 분야에서 인기가 있으며 DeepLab, 다중 스케일 컨택스트 집계, DUC-HDC, DenseASPP, ENet 등이 있습니다.
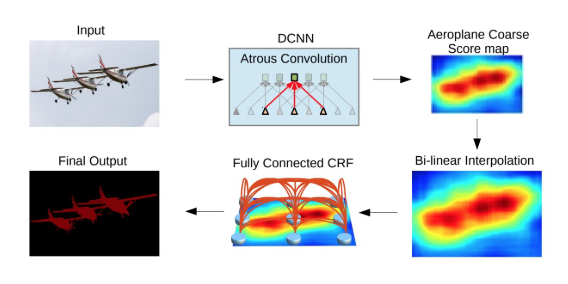 Figure 13 : The DeepLab model.
최근의 DeepLabv2는 max-pooling과 striding으로 인해 네트워크의 해상도가 감소하는 문제를 해결하기 위해 해당 방법을 사용하고, Atrous Spatial Pyramid Pooling(ASPP)을 사용하여 여러 샘플링 비율로 들어오는 합성곱 특징 층을 조사하여 여러 스케일에서 견고하게 세그먼트 합니다. 또한, 확률 그래픽 모델의 방법을 결합하여 객체 경계의 정확한 위치를 개선합니다.
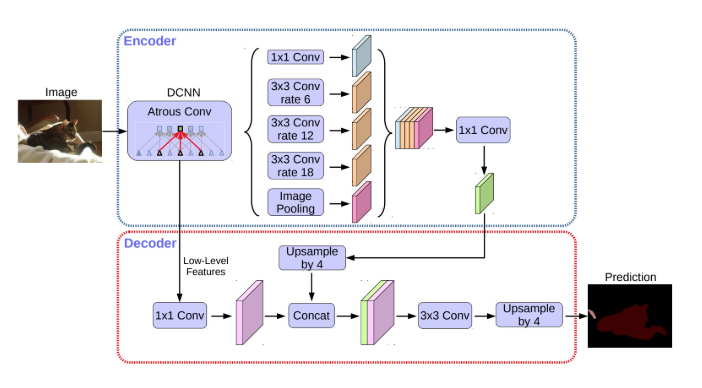 Figure 14 : The DeepLabv3+ model.
2018년에 인코더-디코더 아키텍처의 Deeplabv3+를 게재했으며 2012 PASCAL VOC 챌린지에서 89.0%의 성능을 보였습니다.
Ⅶ. Recurrent neural network based models
CNN이 컴퓨터 비전 문제에 유일한 방법은 아닐 수 있습니다. RNN을 통해 전역 컨텍스트인 픽셀 간의 단기 및 장기 의존성을 모델링하여 의미론적 세그먼트 맵의 추정을 개선할 수 있습니다.
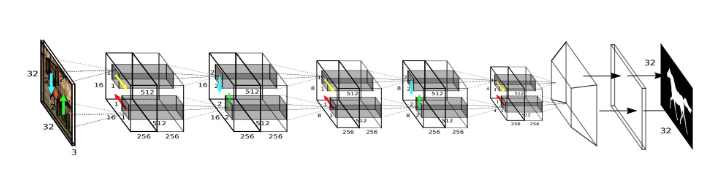 Figure 15 : The ReSeg model.
위와 같은 ReSeg 모델은 원래 이미지 분류를 위해 개발된 ReNet을 기반으로 이미지를 수평 및 수직 방향으로 스위핑하는 네 개의 RNN으로 구성되며, 패치 및 활성화를 인코딩하고 관련 전역 정보를 제공합니다.
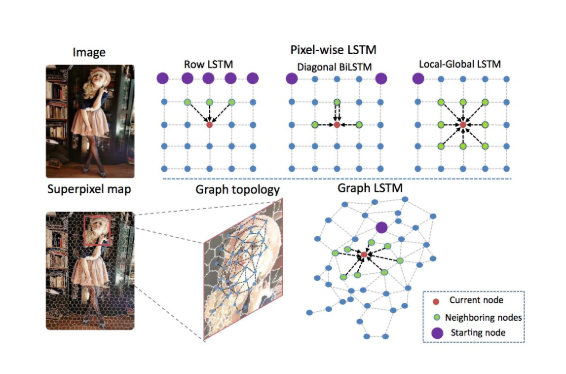 Figure 16 : graph-LSTM model과 픽셀 단위의 RNN models의 비교
그 다음으로 2D LSTM 네트워크를 사용하여 라벨의 복잡한 공간적 의존성을 처리하며, 이를 통해 분류, 세그먼트화 및 컨텍스트 통합이 단일 모델 내에서 모두 수행됩니다.
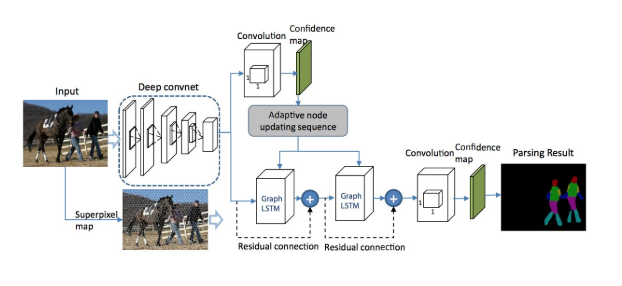 Figure 17 : The graph-LSTM model for semantic segmentation.
이 후 LSTM을 시퀀스 데이터나 다차원 데이터에서 일반 그래프 구조 데이터로 일반화한 Graph LSTM 네트워크 기반의 모델이 제안되었습니다. 기존 다차원 LSTM 구조에서 이미지가 픽셀이나 패치로 균일하게 나뉘는 대신, 이 모델은 임의 모양의 슈퍼픽셀을 노드로 사용하며, 슈퍼픽셀의 공간적 관계를 자연스럽게 엣지로 사용하여 무방향 그래프를 구성합니다. 슈퍼픽셀 맵에 구축된 LSTM 레이어는 합성곱 특징을 글로벌 컨텍스트로 향상시켜 세그먼트화 정확도를 개선시킵니다.
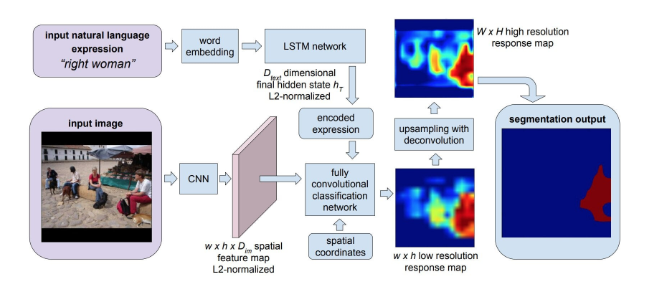 Figure 18 : The CNN+LSTM architecture
Data Associated Recurrent Neural Networks(DA-RNNs)는 3D 장면 매핑과 의미론적 라벨링을 공동으로 수행하기 위해 제안되었습니다. 이는 RGB-D 비디오의 의미론적 라벨링을 위해 새로운 RNN 아키텍처를 사용하며, 이를 Kinect-Fusion과 같은 매핑 기술과 통합하여 재구성된 3D 장면에 의미론적 정보를 결합합니다.
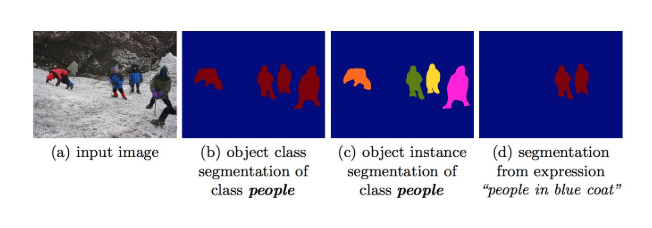 Figure 19 : 자연어 쿼리 기반의 세그멘테이션
위의 모델은 자연어 쿼리를 사용하여 세그먼트 대상을 정의하는 알고리즘으로 이미지 인코딩에 CNN과 자연어 인코딩에 LSTM을 사용합니다.
지금까지 RNN 기반 모델을 살펴보았는데, 해당 모델들은 RNN이 가지는 1D의 순차적인 특징 때문에 2D 이미지에서 CNN에 비해 속도가 느리고 병렬이 어렵다는 제약이 존재하지만 CNN 이 외의 방법으로도 세그멘테이션이 가능하다는 점이 존재한다는 것입니다.
Ⅷ. Attention-based models
자연어 분야에서 큰 성공을 거둔 어텐션 매커니즘은 컴퓨터 비전 분야에서도 지속적으로 탐구되어 왔습니다. 이러한 노력으로 각 픽셀 위치에 다중 스케일 기능을 부드럽게 가중하는 방법이 제안되었습니다. 해당 방법은 평균 및 최대 풀링을 넘어서며 모델이 다른 위치 및 스케일에서 기능의 중요성을 평가할 수 있게 하였습니다. 즉, 아래와 같은 그림에서 어텐션 모델은 스케일이 다른 객체에 다른 가중치를 할당하는 방법을 학습합니다.
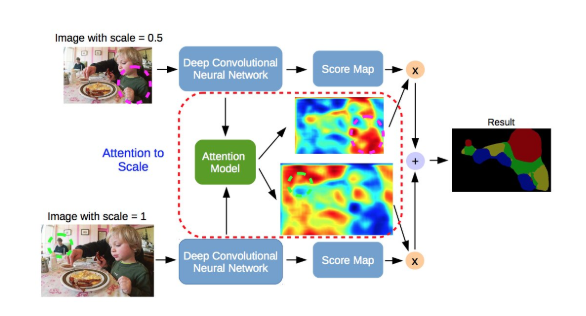 Figure 20 : Attention-based semantic segmentation model.
RAN(Reverse Attention Network)은 일반적인 컨볼루젼을 학습시키는 연구와 대조적으로 반대의 개념인 객체와 관련이 없는 기능을 수집하도록 학습하는 역주목 매커니즘을 사용하여 직접 및 역주목 학습 과정을 동시에 수행하는 세 개의 분기 네트워크를 제안했습니다.
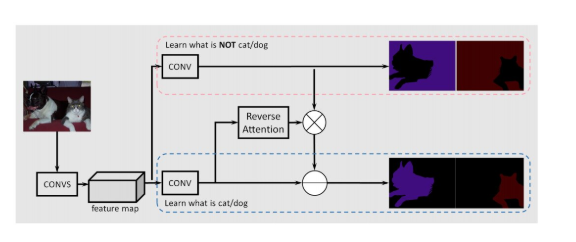 Figure 21 : The reverse attention network for segmentation.
또 다른 어텐션 기반의 모델로 피라미드 형태의 어텐션 네트워크가 제안되었습니다. 해당 모델은 전역 컨텍스트 정보의 영향을 활용하여 어텐션 매커니즘과 공간 피라미드를 결합하였으며 OCNet, EMANet, CCNet 등의 다양한 모델이 소개되었습니다.
Ⅸ. Generative models and adversarial training
GAN을 이미지 분할에도 채택하여 semantic segmentation을 위한 적대적 학습 방식을 제안하였습니다. 컨볼루젼으로 네트워크를 학습시키고, 실제 마스크와 구별하는 방식으로 적대적 네트워크를 함께 학습시키는 접근 방식입니다. 이는 PASCAL VOC 2012 데이터셋에서도 유의미한 정확도의 향상을 야기하였다고 합니다.
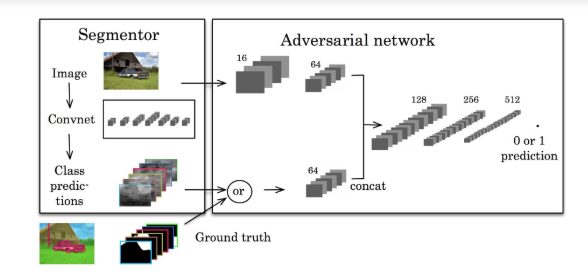 Figure 22 : The GAN for semantic segmentation
또한, GAN을 이용하여 super-weakly 지도 학습 방법을 제안하여 다중 클래스 분류기에 추가 샘플을 제공해 가짜 샘플을 판별합니다. 이 외에도 GAN을 활용하여 semi-supervised 방법이나 다중 스케일 L1 Loss를 채택하는 등 많은 방식의 시도가 존재했습니다.
Ⅹ. Convolutional models with active contour models
FCN(전체 합성곱 네트워크)과 ACM(활동 윤곽 모델) 간의 상호 작용 연구가 진행 되었으며 전역 에너지 공식에서 영감을 받아 FCN의 학습 중 예측된 마스크의 영역 및 크기 정보를 통합하는 지도 손실 레이어를 구성하여 심장 MRI에서 심실 분할 문제를 해결하였습니다. 다른 접근 방식으로는 ACM을 FCN 출력의 후처리기로 활용하는 방법들로 진행되어 Deep Active Lesion Segmentation(DALS), Deep Structured Active Contours(DSAC), Deep Active Ray Network(DarNet), Deep Convolutional Active Contours(DCAC) 등의 모델들이 제안되었다고 합니다.
Ⅺ. Other models
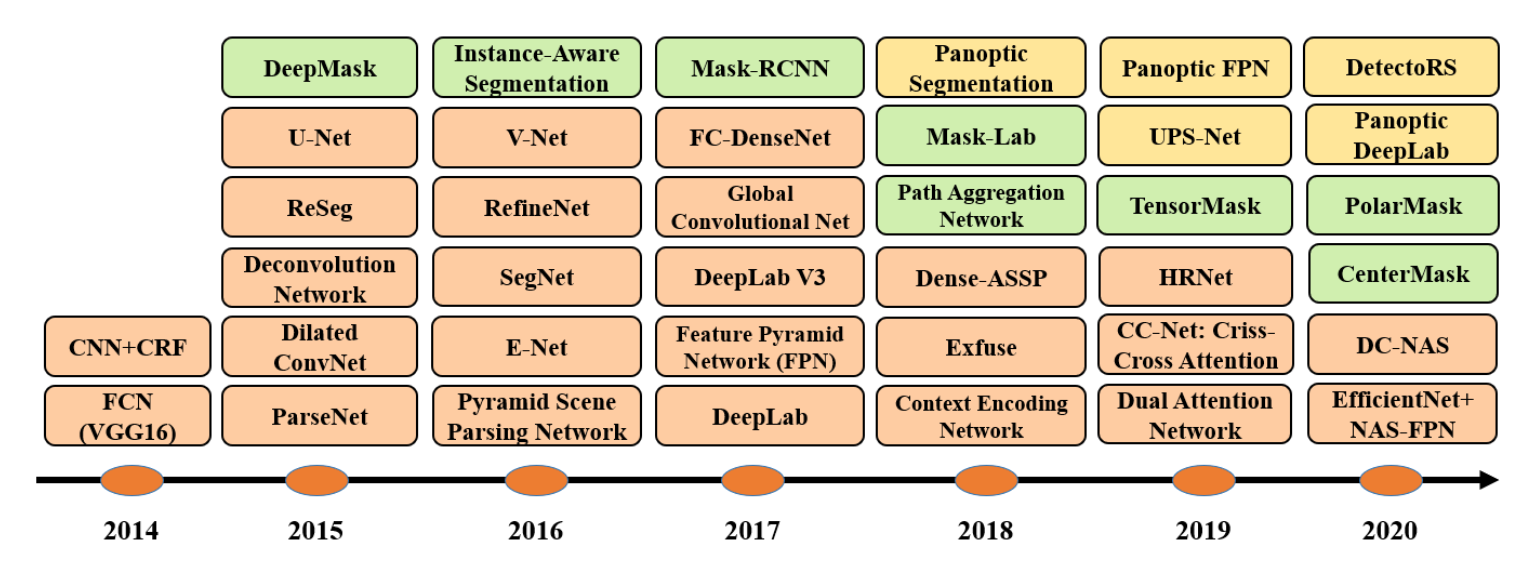 Figure 23 : 2014년도 부터 2020년도 까지의 타임라인으로 오렌지, 그린, 옐로우 색은 각각 semantic, instance, panoptic을 의미합니다.
Ⅻ. Dataset
ⅰ. 2D 데이터셋
PASCAL Visual Object Classes (VOC)
- 21가지의 클래스(차량, 동물 등)로 대부분의 알고리즘들이 해당 데이터셋에서 평가됨.
PASCAL Context
- PASCAL VOC 2010의 확장 버전으로 400개 이상의 클래스를 지님.
Microsoft Common Objects in Context (MS COCO)
- 91개의 객체 클래스로 총 200k 이상의 이미지를 가지고 있음.
Cityscapes
- 30개의 클래스로 도시 거리 이미지를 수집하였음.
ADE20K / MIT Scene Parsing (SceneParse150)
- 장면 파싱 알고리즘을 위한 20K의 장면 중심 이미지로 객체에 대한 상세한 주석 포함.
SiftFlow
- LabelMe DB에서 가져온 2,688개의 이미지 데이터셋
Youtube-Objects
- 유튜브에서 수집된 비디오가 수집된 데이터셋
KITTI
- 다양한 센서 모달리티를 사용하여 기록된 트래픽 시나리오 비디오 데이터셋
기타 데이터셋
- Semantic Boundaries Dataset (SBD), PASCAL Part, SYNTHIA, Adobe’s Portrait Segmentation 등
ⅱ. 2.5D 데이터셋
NYU-D V2
- Microsoft에서 녹화된 다양한 실내 장면 비디오 시퀀스
SUN-3D
- 대규모 RGB-D 비디오 데이터셋
SUN RGB-D
- 주요 장면 이해 작업의 최신 기술 발전을 목표로 하는 RGB-D 벤치마크
UW RGB-D Object Dataset
- Kinect 스타일 3D 카메라로 녹화된 300개의 일반적인 가정용 물체
ScanNet
- 2.5백만 개의 뷰가 포함된 RGB-D 비디오 데이터셋, 1,500개 이상의 스캔
ⅲ. 3D 데이터셋
Stanford 2D-3D
- 2D, 2.5D, 3D 도메인에서 다양한 모달리티를 제공한 RGB 이미지 데이터셋
ShapeNet Core
- ShapeNet 데이터셋의 하위집합으로 55개의 일반 객체 카테고리를 가짐
Sydney Urban Objects Dataset
- 일반 도시 도로에서 수집된 631개의 개별 객체 스캔 데이터셋
Ⅷ. Metric
모델의 평가는 양적인 정확도, 속도(추론 시간), 저장 요구사항(메모리 풋프린트) 등의 다양한 관점에서 평가되어야 합니다. 그러나 대부분의 연구에서는 모든 영역을 평가하기는 어렵기에 가장 유명한 세그멘테이션 알고리즘의 정확도를 평가하기위한 메트릭을 소개합니다. 이렇게 양적인 메트릭이 벤츠마크에서 다른 모델과 비교에 사용되지만 사람이 마지막에 소비하기 때문에 모델의 시각적인 질이 모델의 비교에 대해서도 매우 중요합니다.
\[PA = \frac{\sum_{i=0}^{K} p_{ii}}{\sum_{i=0}^{K} \sum_{j=0}^{K} p_{ij}}\]ⅰ. Pixel Accuracy(PA)
픽셀 정확도는 올바르게 분류된 픽셀의 비율을 총 픽셀 수로 나눈 값으로 K+1개의 클래스(K:foregorund; 1:backgorund)에 대한 정확도는 위와 같이 정의됩니다. 여기서 \(p_{ij}\)는 클래스 \(i\)의 픽셀이 클래스 \(j\)로 예측된 픽셀 수를 나타냅니다.
ⅱ. Mean Pixel Accuracy(MPA)
평균 픽셀 정확도는 각 클래스별로 올바른 픽셀의 비율을 계산한 후 전체 클래스 수에 대해 평균을 낸 값입니다. 간단히 말해 클래스별 비율의 평균입니다.
\[MPA = \frac{1}{K + 1} \sum_{i=0}^{K} \frac{p_{ii}}{\sum_{j=0}^{K} p_{ij}}\]ⅲ. Intersection over Union(IoU) or Jaccard Index
교차 엔트로피 또는 자카드 지수는 예측된 분할 맵과 실제 정답 분할 맵 사이의 교차 영역을 두 맵의 합집합 영역으로 나눈 값으로 정의됩니다.
\[IoU = J(A, B) = \frac{|A \cap B|}{|A \cup B|}\]여기서 \(A\)와 \(B\)는 각각 실제 정답과 예측된 분할 맵으로 해당 값은 0에서 1 사이의 범위를 가집니다. 평균 IoU(Mean-IoU)는 모든 클래스에 대해 IoU의 평균을 계산한 값으로, 현대의 세그먼테이션 알고리즘 성능을 보고할 때 널리 사용됩니다.
ⅳ. Precision, Recall, F1 score
정밀도, 재현율, F1 점수는 고전적인 분류문제의 정확도를 보고하는 데 널리 사용되는 지표로 정밀도와 재현율은 각 클래스별로, 그리고 전체 수준에서 정의됩니다.
\[Precision = \frac{TP}{TP + FP}, \quad Recall = \frac{TP}{TP + FN}\]위의 지표를 결합한 F1 score는 정밀도와 재현율의 조화 평균을 통해 아래와 같이 정의됩니다.
\[F1-score = \frac{2 \times Precision \times Recall}{Precision + Recall}\]ⅴ. Dice coefficient
Dice 계수는 이미지 세그먼테이션에서 많이 사용되는 또 다른 지표로, 특히 의학 이미지 분석에서 많이 사용됩니다. 이는 예측된 맵과 실제 정답 맵의 겹치는 영역을 두 이미지의 총 픽셀 수로 나눈 값을 두 배로 한 것으로 IoU와 매우 유사합니다.
\[Dice = \frac{2|A \cap B|}{|A| + |B|}\]이진 데이터에 적용될 때, foreground가 양성 클래스라고 할 경우 Dice 계수는 F1 점수와 동치하게 됩니다.
\[Dice = \frac{2TP}{2TP + FP + FN} = F1\]Ⅸ. REFERENCES