[CV]SAM
해당 논문은 메타에서 진행한 Segment Anything Model(SAM) 프로젝트로 이미지 세그멘테이션을 파운데이션 모델의 영역으로 확장하는 내용을 다루고 있습니다.
이 계획의 성공을 위한 세가지 요소로는 아래와 같습니다.
어떤 task가 zero-shot 일반화가 가능한가?모델 아케텍처 간의 상호작용은 무엇인가?어떤 데이터가 이 작업과 모델에 강력한가?
해당 논문은 프롬프트화 가능한 세그멘테이션 작업을 정의하는 것부터 시작하며, 일반적으로 강력한 사전학습 모델을 제공하기 위해 충분한 데이터와 설계 원칙을 제시하였습니다.
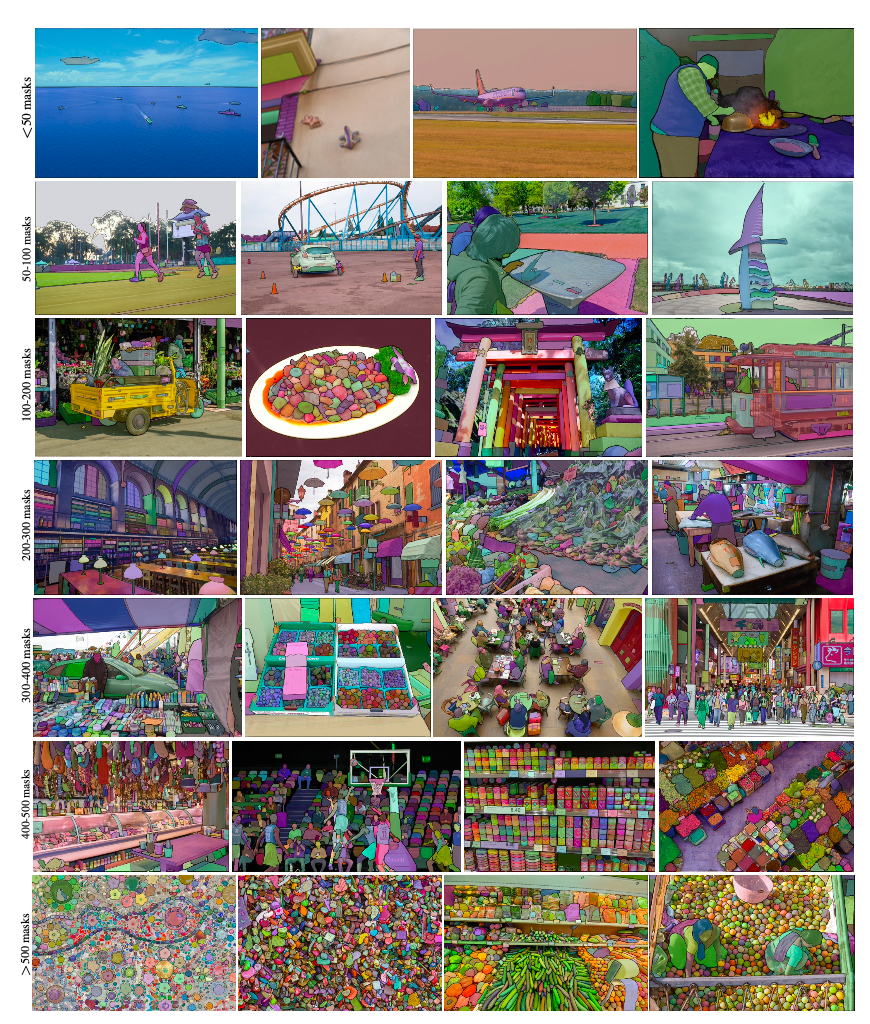 Figure 1 : SA-1B, 11M의 다양하고 높은 해상도를 지닌 세그멘테이션 마스크를 포함한 데이터셋.
Ⅰ. Segment Anything Task
저자들은 다양한 다운스트림 세그멘테이션 작업에 적용 가능한 프롬프트 가능한 세그멘테이션 태스크를 제안하였습니다. 다양한 형태의 프롬프트(전경,배경 점, 상자 또는 마스크, 자유형 텍스트 등)를 제공받아 이미지에서 유효한 분할 마스크를 반환하는 것으로 프롬프트가 모호할 경우에 적어도 하나의 객체에 대한 적절한 마스크를 생성하는 방식입니다.
즉, Zero-shot 전이를 통해 다양한 작업에 자연스럽게 적용될 수 있도록, 프롬프트가 주어지면 유효한 세그멘테이션을 반환하는 세그멘테이션 태스크를 정의했습니다.
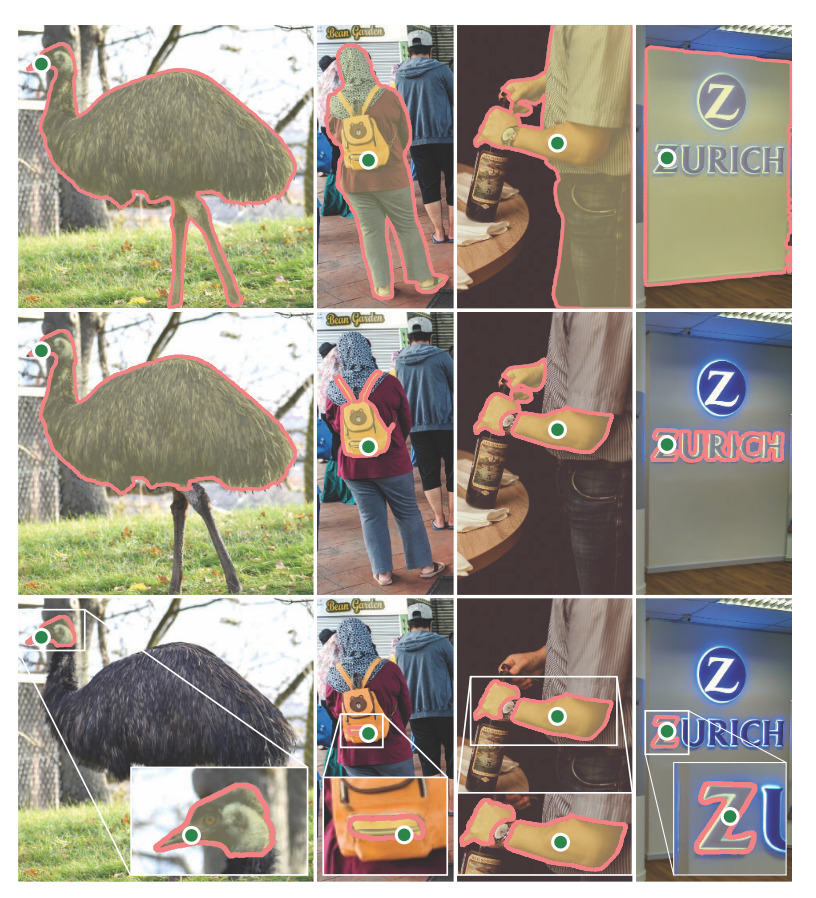 Figure 2 : single ambiguous point prompt로 부터 SAM을 통해 생성된 3가지 유효한 마스크를 보여줌.
이러한 작업을 선택한 이유는 이것이 자연어 처리에 사용되는 프롬프트 기반 접근법이 세그멘테이션에서도 제로샷 전이가 가능하기 떄문입니다.
ⅰ. 사전 학습.
각 학습 샘플에서 프롬프트 시퀀스로 자연어의 사전 학습 알고리즘을 제안합니다. 그리고 모델의 마스크 예측을 실제 마스크와 비교합니다. 여기서 저자들은 상호작용 가능한 세그멘테이션을 채택했으며, 비록 충분한 사용자의 입력 후에 유효한 마스크를 예측하는 상호작용 세그멘테이션과 달리 어느 프롬프트나 심지어 모호한 프롬프트가 들어와도 항상 유효한 마스크를 예측하는 데 목적이 있습니다.
ⅱ. 제로샷 전이.
직관적으로 이 사전학습 작업은 어느 프롬프트던 적절히 반응하는 능력과 적절한 반응 시간을 가지는 모델을 제공합니다. 따라서, 다운스트림 작업은 적절한 프롬프트 엔지니어링으로 해결가능해 다양한 실제 세그멘테이션 작업이 프롬프팅을 통해 수행됩니다. 이러한 프롬프팅과 컴포지션은 단일 모델에서 확장 가능한 강력한 도구로 사용됩니다.(i.e. CLIP이 DALL-E의 이미지 생성 시스템에서 텍스트-이미지 요소를 배열하는 방식과 같이 활용됨)
Ⅱ. Segment Anything Model
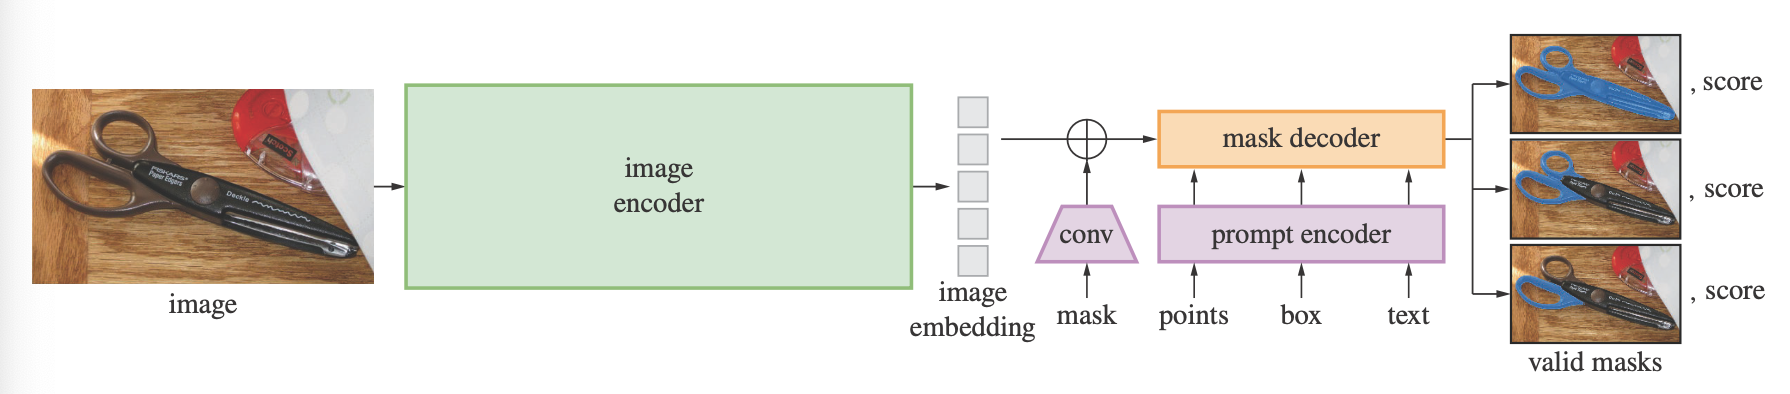 Figure 3 : SAM; 무거운 가중치를 가진 이미지 인코더가 이미지 임베딩을 생성하고, 다양한 입력 프롬프트에 대해 실시간으로 목적 마스크를 효율적으로 실행하여 질의를 처리
ⅰ. Encoder
해당 모델에서 이미지 인코더는 MAE(Masked AutoEncoder)로 사전 학습된 ViT를 사용합니다.
또한, 프롬프트 인코더는 두 가지 세트의 프롬프트로 sparse(point, box, text)와 dense(mask)를 사용합니다. 포인트와 박스는 각 프롬프트 타입에 대해 학습된 인코딩의 합인 포지셔널 인코딩으로 표현되며, 자유형식의 텍스트는 CLIP에서 제공하는 off-the-shelf 텍스트 인코더를 사용합니다. Dense 프롬프트는 컨볼루션을 사용하여 임베딩되고, 이미지 임베딩과 더해져 element-wise로 처리됩니다.
ⅱ. Decoder
마스크 디코더는 이미지 임베딩과 프롬프트 임베딩을 효율적으로 매핑하고, 출력 토큰을 마스크로 매핑합니다. 수정된 디코더 블럭은 프롬프트의 셀프-어텐션을 사용하며, 두 방향(“Two-way”)에 대해 크로스 어텐션(프롬프트와 이미지 임베딩)을 통해 모든 임베딩을 업데이트합니다. 두 블록을 실행하기 전에 이미지 임베딩을 업샘플링하고, MLP 맵을 통해 출력 토큰을 동적 선형 분류기로 매핑합니다. 이를 통해 마스크의 전경 확률을 각 이미지 위치에서 계산할 수 있습니다.
ⅲ. Ambiguity solve
모델은 하나의 출력에서 여러 유효한 마스크의 평균을 계산하여, 애매모호한 프롬프트가 주어졌을 때 이를 해결합니다. 이를 위해 모델은 단일 프롬프트에서 여러 가지 출력 마스크(3개가 적당하다고 함)를 예측하도록 수정되어야 합니다. 학습 과정에서 마스크에 대해 최소 손실을 역전파하는 방식으로 진행되며, 마스크의 순위를 매기기 위해 모델은 각 마스크에서 예측된 confidence 스코어(ioU 추정값)를 사용합니다.
ⅳ. Efficiency
프롬프트 인코더와 마스크 디코더는 웹 브라우저에서 실행 가능합니다. 이러한 런타임 성능은 전례가 없으며, 현실과 상호작용할 수 있는 수준의 효율성을 제공합니다.
ⅴ. Loss function
마스크 예측을 감독하기 위해 focal loss와 다이스 로스의 선형 조합을 사용합니다.
Ⅲ. Segment Anything Data Engine
데이터가 부족하여 데이터 엔진을 만들었으며 세가지 단계로 model-assisted manual annotation stage, semi-automatic stage, fully automatic stage 로 구성하였습니다.
첫 번째 단계에서는 어노테이터가 포인터를 사용하여 전경과 배경 물체를 클릭하며 어노테이션을 진행합니다. 세미 오토매틱 단계에서는 마스크의 다양성을 증가시키는 것을 목표로, 덜 중요한 물체에 집중합니다. 먼저 자동적으로 신뢰도가 높은 마스크를 찾은 후, 어노테이터는 이미지에 이미 채워진 마스크를 기반으로 추가적인 어노테이션을 진행하고, 아직 어노테이션되지 않은 물체에 대해 작업을 합니다.
Ⅳ. Segment Anything Dataset
데이터셋의 마스크 품질은 랜덤 샘플링을 통해 나온 마스크를 전문 어노테이터가 수정했을때 계산한 ioU로 90% 이상의 품질이었다고 합니다.
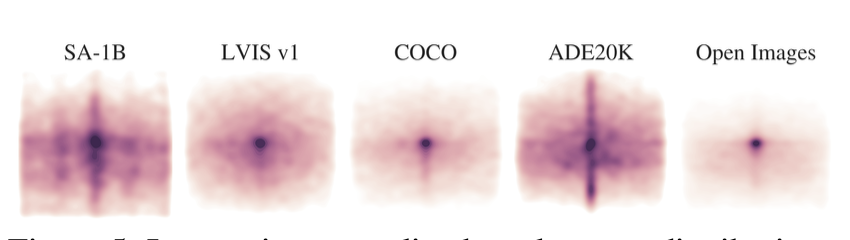 Figure 4 : 이미지 크기의 정규화된 마스크 중심 분포
위 사진과 같이 해당 데이터셋에서의 마스크는 이미지 중심에 대한 분포가 덜합니다.
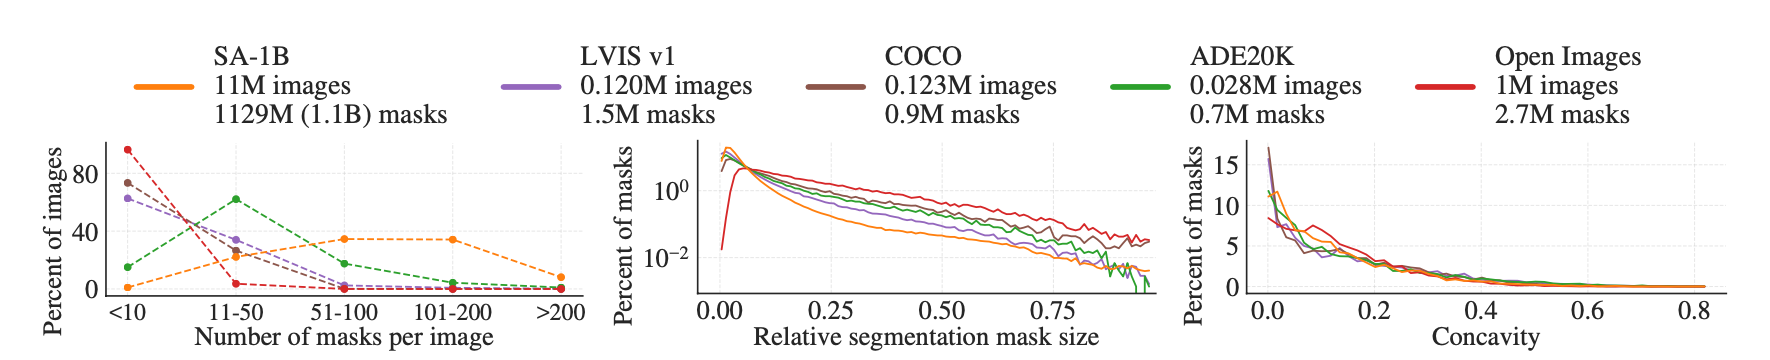 Figure 5 : 데이터셋 마스크 속성.
이미지의 크기는 대체로 이전의 데이터셋과 비교하여 11배 많은 이미지와 400배 더 많은 마스크를 포함하고 있으며 이미지당 더 많은 마스크와 작고 중간 크기의 마스크 비율이 더 높습니다. 그리고 마스크 복잡도 분포를 마스크 크기별로 층화 샘플링을 한 결과 대체로 유사한 것으로 나타났습니다.
Ⅴ. Segment Anything RAI Analysis
Responsible AI(RAI) 분석으로 모델이 지리적 및 소득 분포와 인식되는 성별, 연령, 피부 등으로 성능 차이 평가했으나 유의미한 차이는 없었습니다.
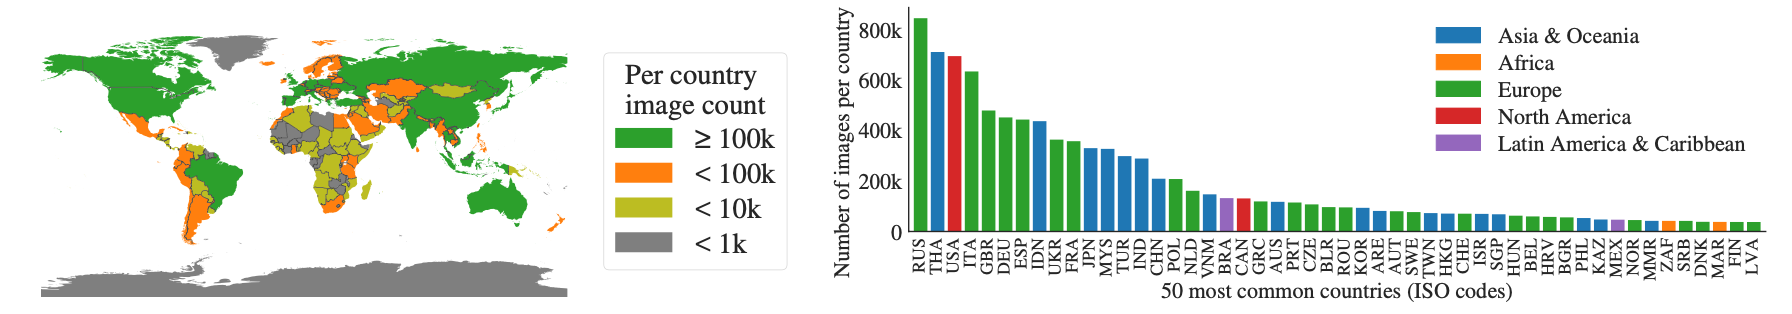 Figure 6 : 이미지의 지역적 분포
Ⅵ. Zero-Shot Transfer Experiments
실험에서는 프롬프트 기반 세그멘테이션의 주요 목표를 테스트하는 방식으로 진행되었으며 목표는 각기 다른 프롬프트로부터 유효한 마스크를 생성하는 것입니다. 다양한 전경 포인트 프롬프트를 사용하여 실험을 수행하였고, 프롬프트 엔지니어링을 통해 향상되었으며, SAM을 이용한 학습을 통해 성능이 개선되었다고 합니다. 아래는 해당 실험 결과표들 입니다.
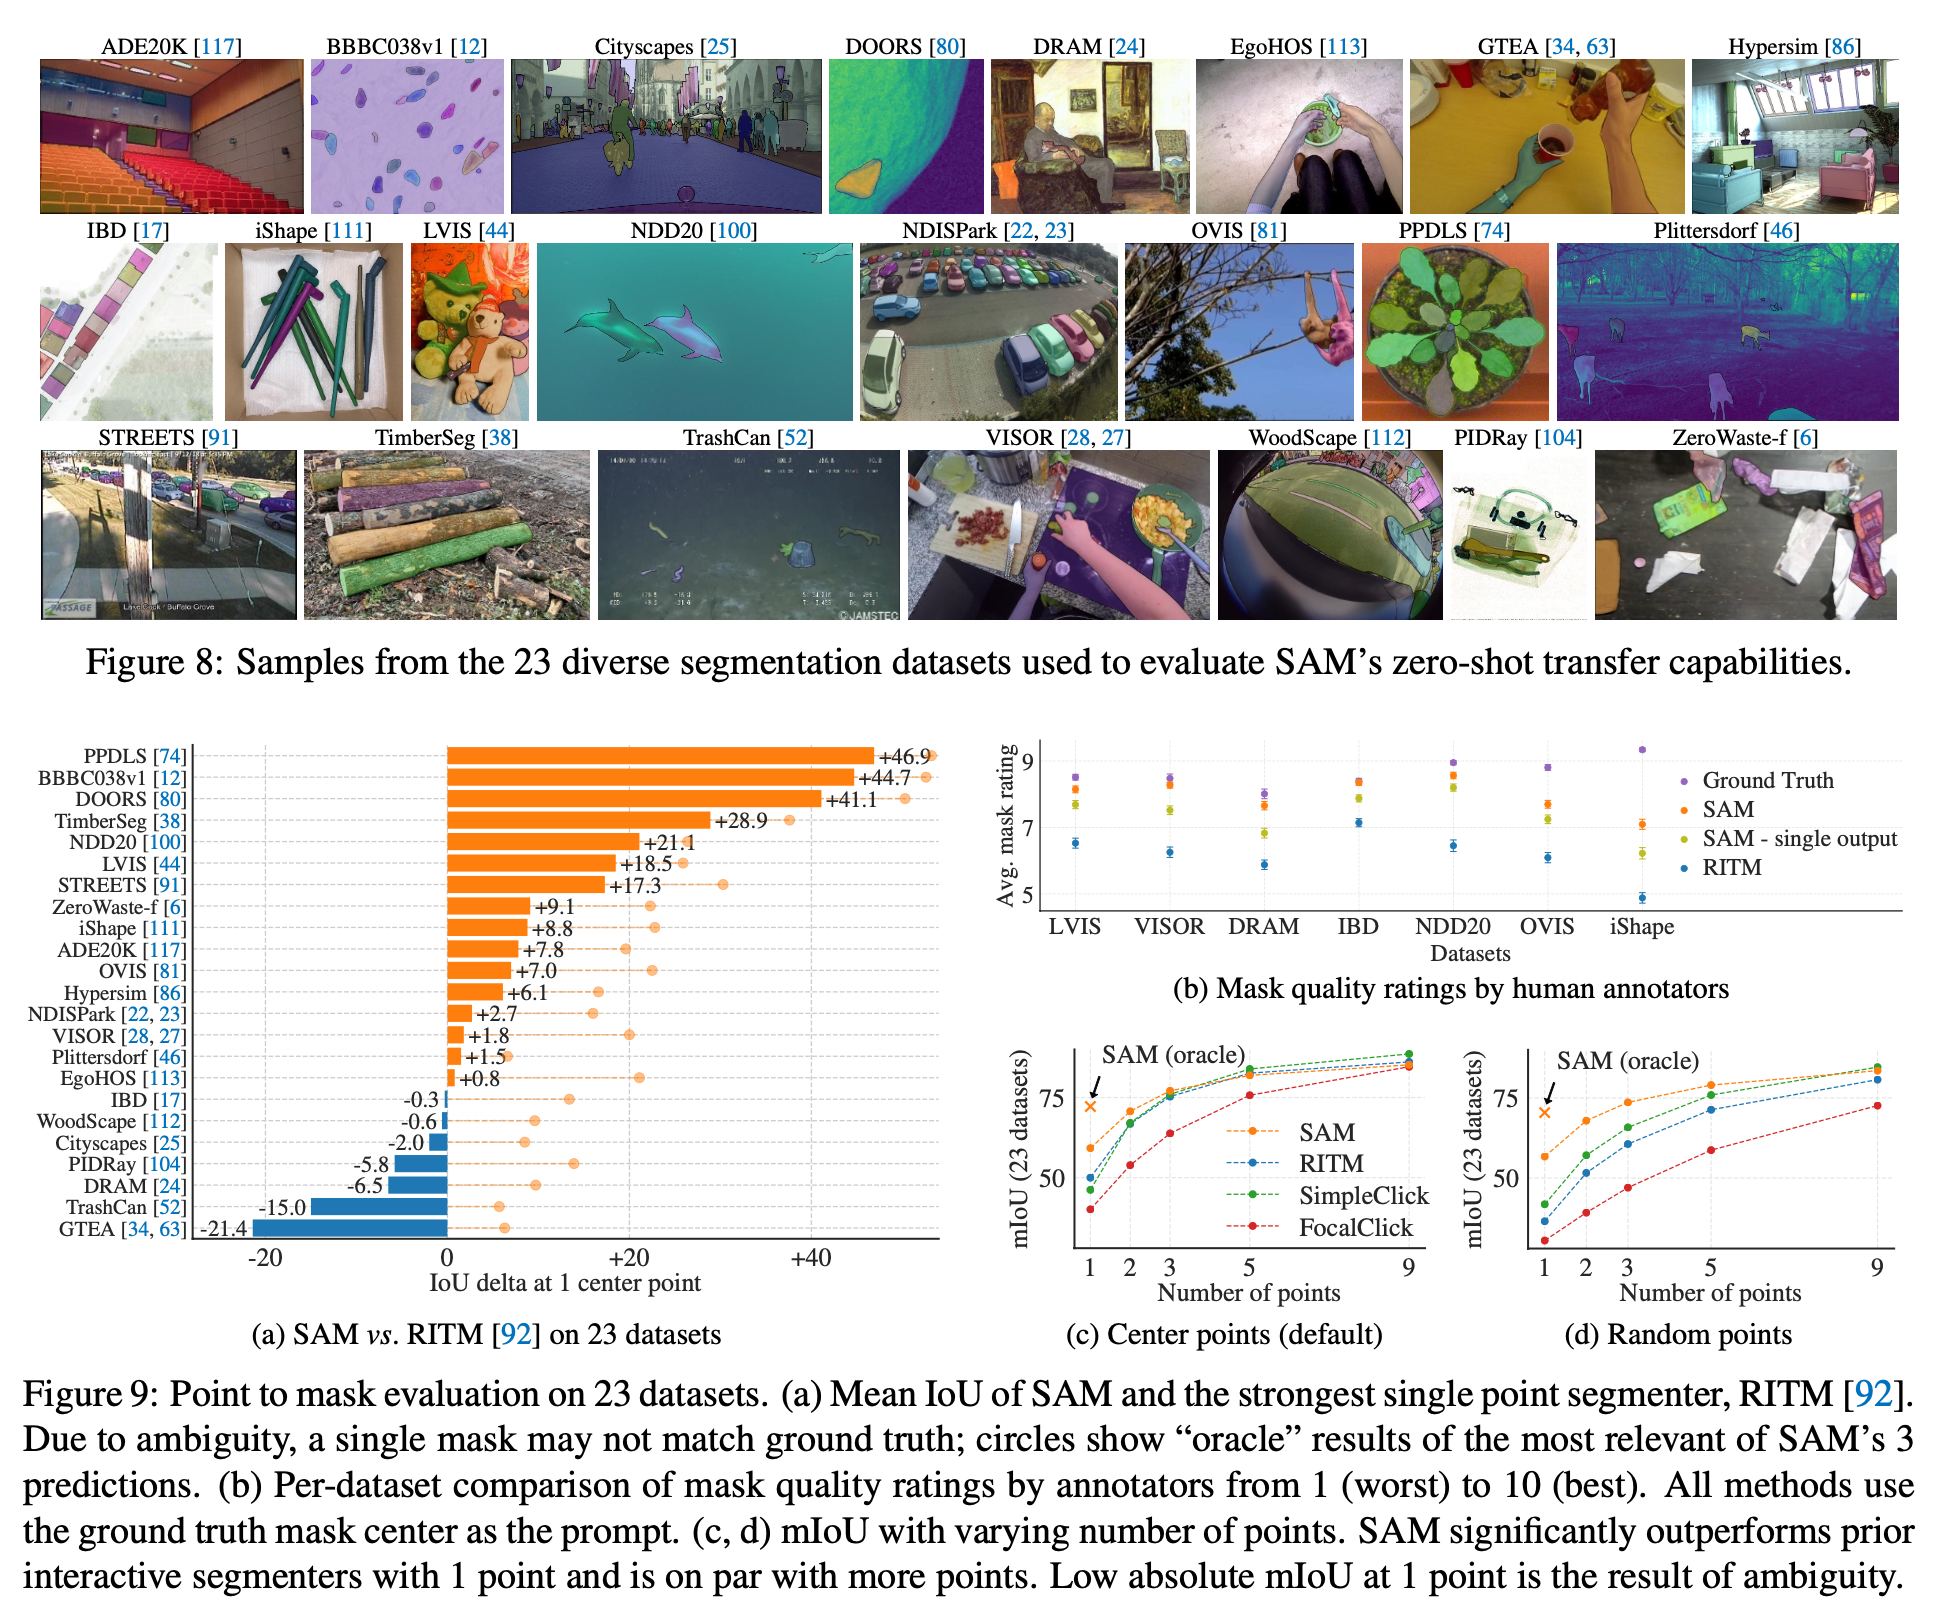 Figure 7 : 대부분의 데이터셋에서 일관되고 높은 성능을 유지함을 보여줌.
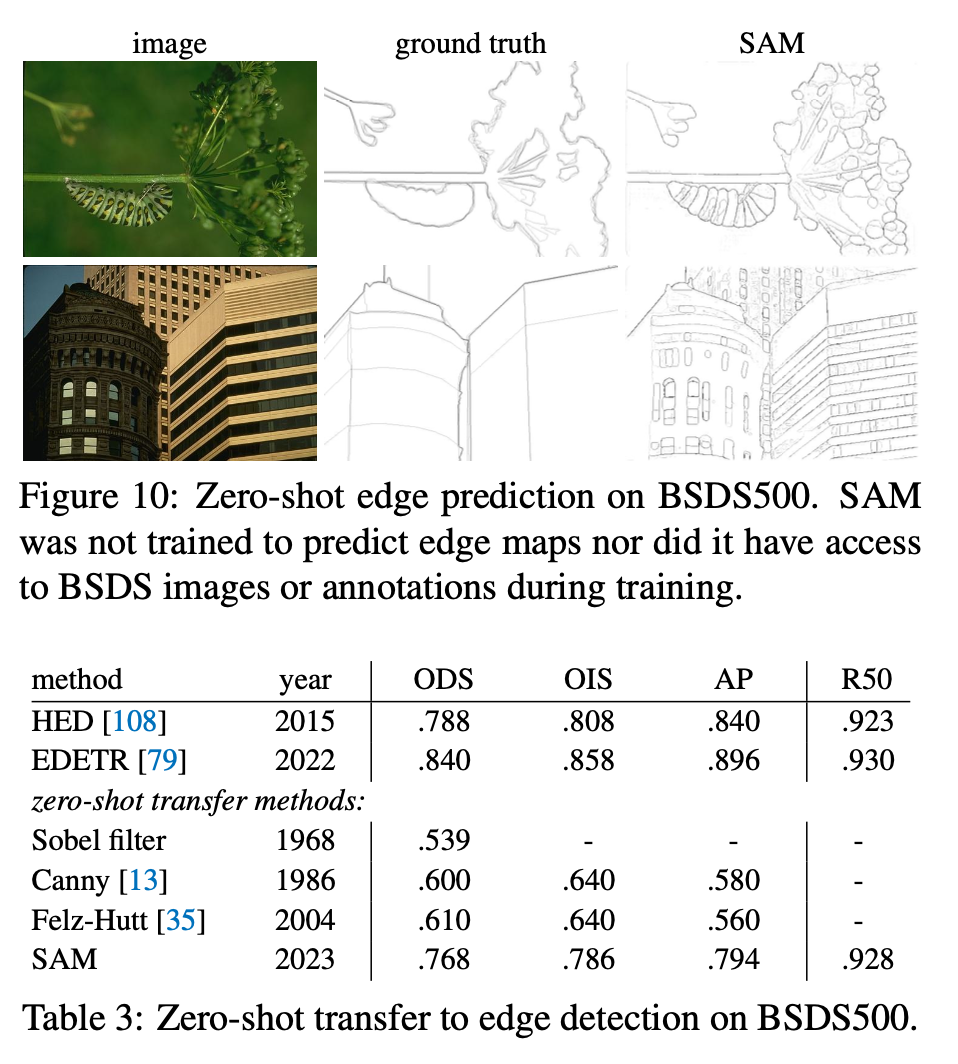 Figure 8 : SAM이 더 높은 성능을 보여줌
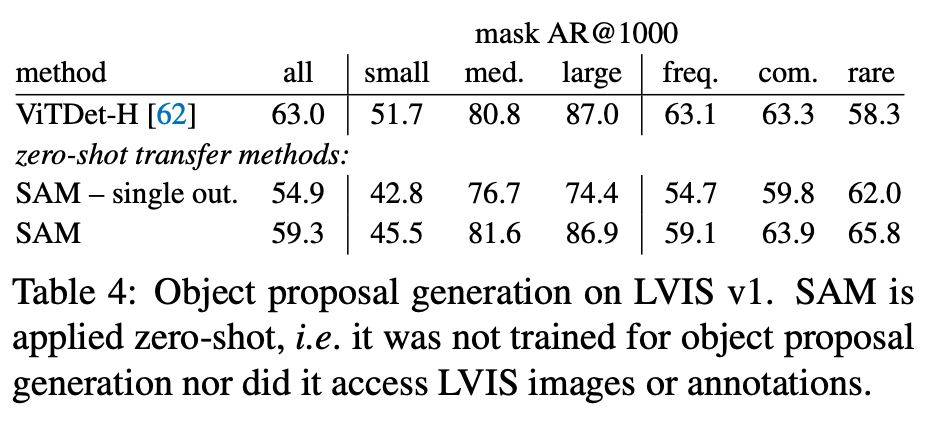 Figure 9 : Zero-Shot Object Proposals
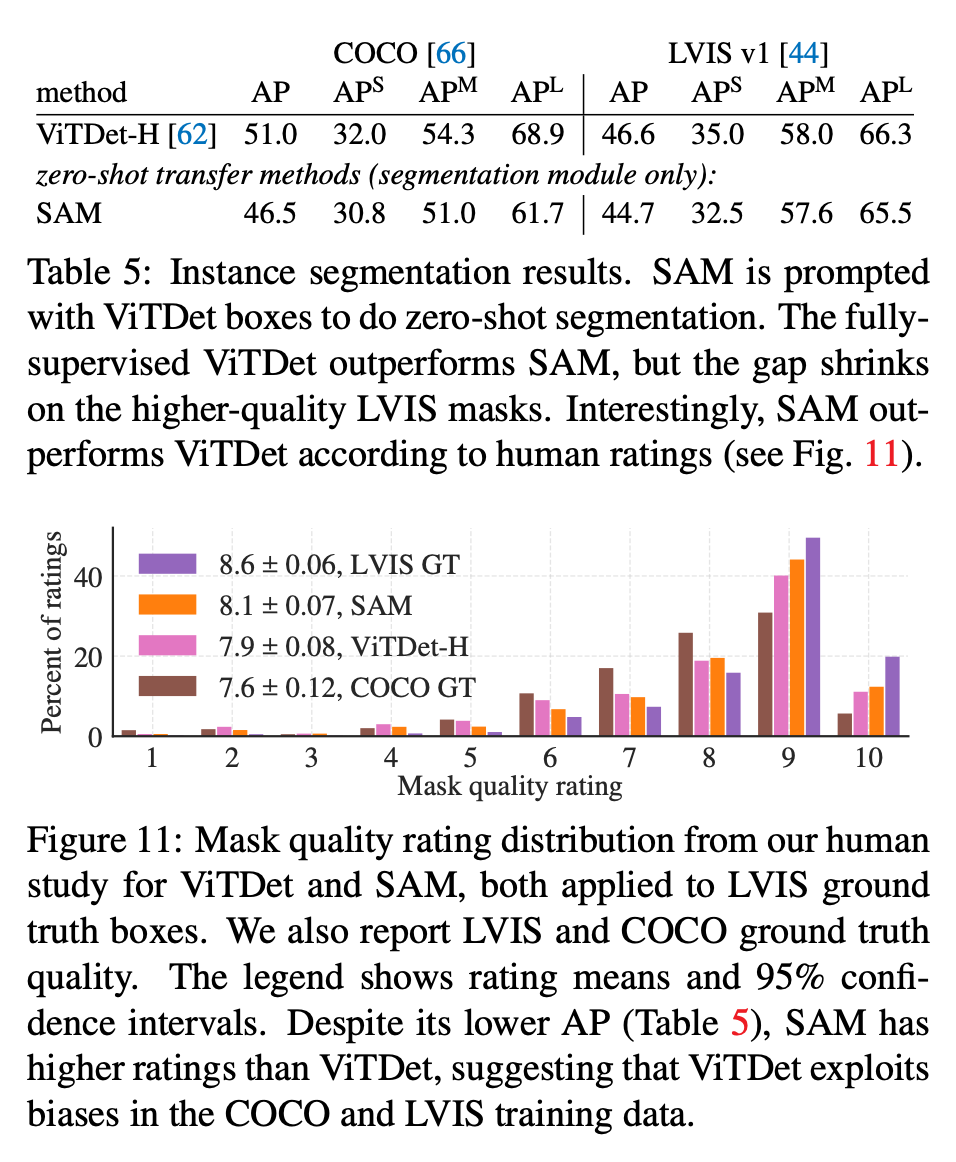 Figure 10 : SAM의 마스크는 경계가 더 선명하여, ViTDet의 마스크보다 시각적으로 더 나은 품질을 보였습니다. 이를 확인하기 위해 추가 사용자 평가를 진행했으며, SAM이 ViTDet보다 일관되게 높은 점수를 받았습니다.
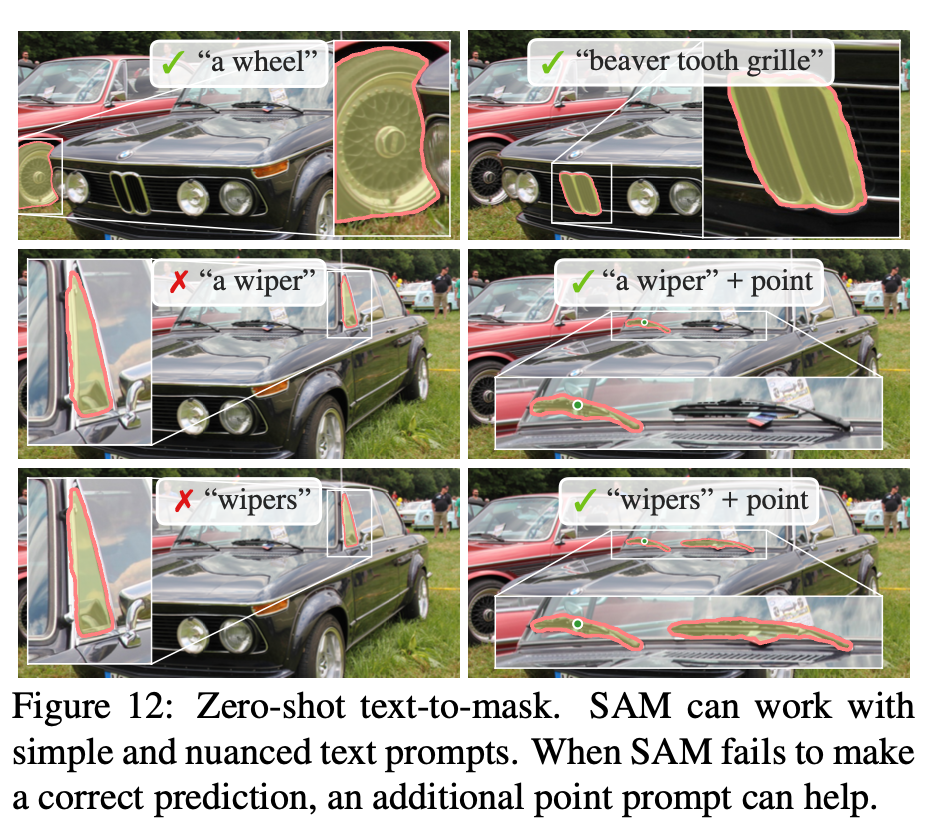 Figure 11 : SAM은 “a wheel”과 같은 간단한 텍스트 프롬프트나 “beaver tooth grille” 같은 문구를 기반으로 객체를 세분화할 수 있습니다. SAM이 텍스트 프롬프트만으로 올바른 객체를 선택하지 못할 경우, 추가 지점을 지정하면 예측이 정확해지는 경향이 있습니다.
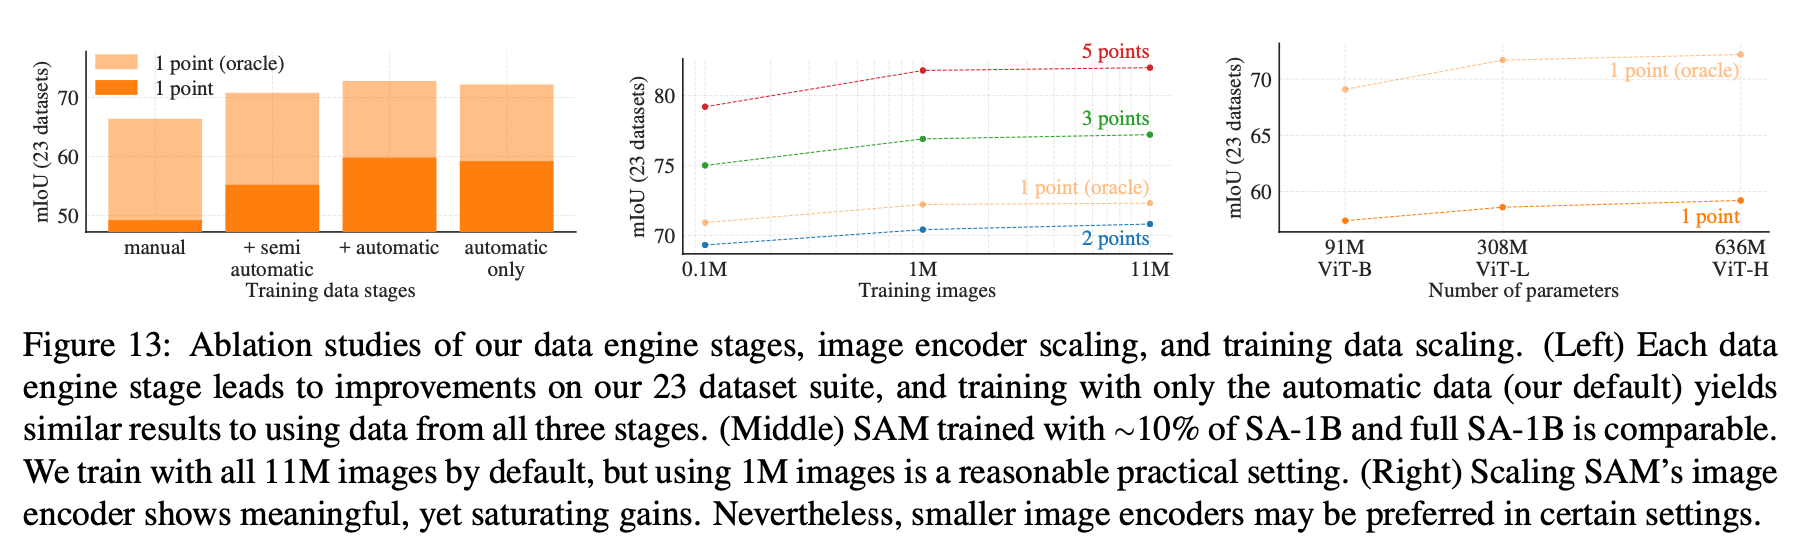 Figure 12 : 단일 포인트는 모호할 수 있어 상위 마스크가 데이터셋의 어노테이션 기준과 다를 수 있어, 최적의 마스크를 별도로 기록함. 각 단계별로 학습 시 mIOU가 증가함. 데이터 볼륨 영향. 이미지 인코더 업그레이드 성능 향상 이 발생
Ⅶ. for Medical Image Segmentation
파운데이션 모델인 SAM을 의료 영역에 적용하는 landscape를 제공한 “Segment Anything Model for Medical Image Segmentation: Current Applications and Future Directions” 논문을 간단히 소개하겠습니다.
의학 이미지의 세그멘테이션은 특정 해부학적인 구조를 포착하는 데 집중되어있습니다. 그러나 최근에는 다양한 모달리티와 목표에 맞춘 새로운 접근법들이 등장하고 있습니다. 대규모 파운데이션 모델들이 부상하면서 제로샷과 퓨샷의 일반화 능력을 통해 의료 분야에서도 넓은 범위의 다운스트림 작업이 가능해졌습니다. 해당 논문을 통해 SAM을 의료 이미지 세그멘테이션으로 넓히는 노력들을 요약함으로써 해당 분야의 넓은 식견을 엿볼 수 있었습니다.
SAM은 CT, MRI, Pathological(병리학), Colonoscopic(대장내시경), Endoscopic(내시경) 등 다양한 모달리티에서 적용이 가능합니다. 기존의 SOTA 방법들과 비교하여 주목할 만한 성능을 보여주었으나 약한 바운더리, 낮은 대조, 작은 사이즈, 불특정한 모양 등 특정 한계를 통해 도전적인 상황에 마주하고 있습니다. SAM을 파인튜닝이나 재학습없이 사용하면 SA-1B를 통해 학습되었기에 이러한 새롭고 도전적인 의료 이미지 세그멘테이션에서의 성능 제약은 당연한 수순이 된다고 합니다.
ⅰ. Fine-tuning on Mdeical Images
파인튜닝 측면에서 다룬 내용입니다.
전체 파인튜닝(Full Fine-tunning)MedSAM에서 SAM을 특정 작업에서 바로 파인튜닝 하여 U-Net 기반의 모델 성능을 웃도는 성능을 보였으나 3D 이미지를 2D 슬라이스의 시리즈로 변환하여 사용하는 등의 제약이 있었습니다.
효율적인 파라미터 파인튜닝(Parameter-efficient Fine-tunning)SAM의 모든 파라미터를 업데이트하는 것은 시간이 많이 소요되므로, 작은 부분만 파인튜닝하는 방식이 효율적으로 SAM 파라미터의 작은 부분을 파인튜닝하는데 다양한 PEFT 기술들을 사용했습니다. Med-SA(Medical SAM Adapter)에서는 LoRA 모듈을 통합하는 동안 얼리는 방법을 제안하였고 또한, AdaSAM 같은 경우는 적용형 수정 기법을 통해 bias-tuning으로 상당히 작은 수의 학습 파라미터를 사용하여 자유형식의 텍스트 프롬프트를 활용하여 메디컬 도메인에 텍스트 프롬프트가 가능하게 함. 그리고 자연 이미지와 의료 이미지 사이의 갭을 연결하는 종합적인 연구로 SAM-Med2D도 진행되었음.
ⅱ. Auto-prompting Adaptation
프롬프트 측면에서 다룬 내용으로 SAM의 적용에서 높은 품질의 프롬프트가 필요한데, 낮은 품질의 프롬프트는 노이즈가 많은 마스크를 생성할 수 있으며 세그멘테이션 정확도에 큰 영향을 미치게 됩니다. 따라서, 이를 해결하기 위한 자동 프롬프트 생성 메커니즘이 강건하고 실용적인 프레임워크를 만드는데 중요합니다.
Prompts Auto-generationSAM의 입력 프롬프트를 생성하는 방법으로, YOLOv8을 활용한 바운딩 박스 생성이나 3D 바운딩 박스를 퓨샷 학습을 통해 적용하는 방식이 있습니다.
Learnable Prompts조건적인 프롬프트를 사용하여 입력 이미지의 특징을 자동으로 추출하는 방식으로, AutoSAM은 기존의 전형적인 프롬프트를 넘어서서 고도화된 학습 방법을 제시합니다.
Enhancing Reliability Against Prompts with Uncertainty입력 프롬프트에 대한 불확실성을 추정하여, 신뢰할 수 있는 세그멘테이션 결과를 보장하는 방법이 중요합니다. 이러한 불확실성의 통합은 SAM의 다양한 프롬프트에 대항하여 강건성을 강화할 수 있으며 의료 이미지에서는 이러한 불확실성의 추정이 잠재적인 세그멘테이션 에러를 식별하고, 임상의에게 유용한 가이드를 제공할 수 있습니다.
ⅲ. Framework Modification
의료 이미지 세그멘테이션 모델을 개선하기 위한 새로운 학습 방식들이 개발되고 있습니다.
Synergy in Training Segmentation ModelsnnSAM은 nnUNet과 통합하여 보다 향상된 의료 영상 세그멘테이션 성능을 달성했습니다. 이로써 SAM을 다양한 환경에 유연하게 적용할 수 있는 강력한 모듈로 활용할 수 있게 되었습니다.
Facilitating Annotation-efficient Learning의료 영상 세그멘테이션에는 전문 임상의의 경험이 필요하므로 주석 비용이 매우 높습니다. 이를 해결하기 위해, 반지도 학습 및 약지도 학습과 같은 주석 효율적인 학습 방법들이 활발히 연구되고 있습니다.
ⅳ. Towards 3D Medical IMages
2D 아키텍처를 기반으로 한 SAM은 3D에서 부분 최적화 결과를 제공합니다.
Adaptation From 2D to 3DMed-SA는 Space-Depth Transpose와 같은 기술을 적용하며, 3DSAM-adapter는 nnUNet의 성능을 압도합니다. MA-SAM도 유사한 성능 향상을 보여줍니다.
Training from Scratch3D 의료 이미지 세그멘테이션을 위한 새로운 방법들이 제시되고 있습니다. 예를 들어, SAM-Med3D는 3D 공간 정보를 2D를 통해 3D에 적용하는 접근 방식을 채택하고 있습니다.
ⅴ. Discussion
Building Large-Scale Medical DatasetSA-Ned2D-20M과 SAT (Segment Anything with Text)는 텍스트 프롬프트를 쿼리로 사용하여 다양한 의료 이미지 세그멘테이션 작업을 수행할 수 있습니다. 이를 통해 다양한 모달리티, 해부학적 구조, 그리고 신체 부위에 걸친 작업이 가능해졌습니다.
Accelerating Annotation의료 이미지 주석을 만드는 것은 전문의의 도움이 필요하므로 이러한 주석의 가속화가 중요한 과제로 떠오르고 있습니다.
Scribbleand Prompts의료 이미지에서 장기나 종양 등의 형태가 불규칙하기에 직접 선을 긋는 등 곡선 형태의 스크리블 프롬프트는 도움이 될 수 있습니다.
Multi-ModalMedical다중 모달 의료 이미지는 해부학, 기능, 병리학에 대한 보완적인 정보를 제공할 수 있어 임상에서 중요한 역할이 될 수 있습니다..
Ⅷ. REFERENCES
- 2023, “Segment Anything”, Meta AI Research(FAIT)
- 2024, “Segment Anything Model for Medical Image Segmentation: Current Applications and Future Directions”, Y. Zhang at el