[Paper]SAM
https://www.reddit.com/r/MachineLearning/comments/1aj9swv/repeat_after_me_transformers_are_better_than/?rdt=33854 Repeat After Me: Transformers are Better than State Space Models at Copying
댓글에서는 전체를 바로 참조하는 트랜스포머가 입력을 고정된 크기의 길이의 컨텍스트로 압축하는 SSM 형태보다 당연히 성능차이가 난다는 의미인것 같다.
Beyond Transformers:Structured State Space Sequence Models
트랜스포머 기반의 모델은 학습과 인퍼런스시 많은 코스트가 필요하다고 이야기함. 컨텍스트 윈도우 이내에서 정보를 밀도있게 라우트 하는 능력 덕분에 셀프어텐션의 효율성이 나온다.
Introduction to State Space Models (SSM)
States Spaces Models 은 제어 이론에서 상태 변수를 통해 동적 시스템에서 사용되어왔음. 두뇌가 얼마나 효율적으로 일시적인 정보를 표현하는가에 대한 질문을 다루었고, 두뇌에서 time cells 라고 묘사되는 hippocampus and cortex in particular 를 훌륭한 모델인 SSM을 발견함 2018년에 . 뇌과학에서 이를 딥러닝에 적용함.
S4 모델을 소개함. Efficiently Modeling Long Sequences with Structured State Spaces 2021년에 발간한. 교육적인 목적으로 이 모델을 사용함.
딥러닝에서 SSM을 언급할때 linear invariant system이라 불리우는 것을 말한다. 이 모델은 Efficiently Modeling Long Sequences with Structured State Spaces 논문에서 뛰어난 성능을 보여주었으며 트랜스포머의 대요애으로써 포지셔닝함. S4에 기반한 딥러닝 SSM의 기초를 정의함. 트랜스포머의 논문과 같이. S4는 새로운 타입의 신경 네트워크 모델임. 하지만 실제로 사용되지는 않고 있음.
Definition of an SSM in deep learning
 Figure 1: View of a continuous, time-invariant SSM (Source: https://en.wikipedia.org/wiki/State-space_representation)
A는 State matrix(잠재 상태 x를 컨트롤하는), B는 control matrix, C는 output matrix, D는 Command matrix 입니다. x와 u는 각각 n,m개의 state 변수들이고 y는 p개의 output입니다.(Du=0으로 설정하면 스킵 거넥션처럼 사용)
discretized
이 시스템은 연속적이기에 discretized 이산화가 되어야함 컴퓨터에 들어가기 전에.
이산화는 SSM에서 중요한 포인트이다. 모든 효율적인 아키텍처는 이 작업선상에 놓여있음. 연속적인 시각의 SSM에서 두 가지 다른 시각으로 보내는게 가능함. recursive view와 convolutive view임.
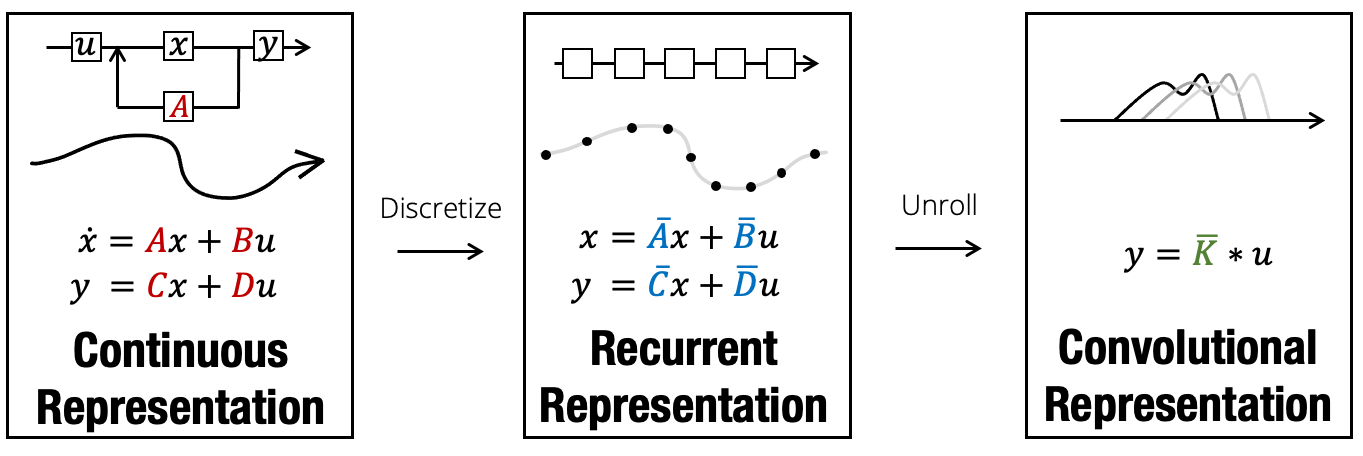 Figure 2: Image from blog post « Structured State Spaces: Combining Continuous-Time, Recurrent, and Convolutional Models » by Albert GU et al. (2022)
모든 효율적인 아키텍처들은 이 작업 선상에 놓여있음.연속적인 시각에서 재귀적인 시각과 컨볼류티브 시각으로.
Recursive view of an SSM
연속적인 케이스를 이산화하기 위해서 trapezoid method(사다꼴 공식) 방법을 사용함.
사다리꼴 공식은 수치 적분에서 사용하는 방법으로 구간 [a,b]를 n개의 작은 구간으로 나누고, 사다리꼴의 모양으로 만들어 면적을 계산하여 모두ㅡ 더함. 이산화는 연속적인 시간, 공간, 또는 데이터를 이산적인 단계로 나누는 수학적 변환과정으로 특정 고정된 간격으로 변할 수 있게 함. 1.1, 1.2, 1.3 등을 특정한 시간 간격인 1,2,3 으로 바꿈.
x_{n+1} - x_n = 0.5*Δ(f(t_n)+f(t_{n+1})), Δ = t_{n+1} - t_n
x_{n+1} = x_n + 0.5Δ(Ax_n + Bu_n + Ax_{n+1} + Bu_{n+1}) x_{n+1} - 0.5ΔAx_{n+1} = x_n + 0.5Δ(Ax_n) + 0.5Δ(Bu_n + Bu_{n+1}) (I - 0.5ΔA)x_{n+1} = (I + 0.5ΔA)x_n + ΔBu_{n+1} x_{n+1} = (I - 0.5ΔA)^{-1}(I + 0.5ΔA)x_n + (I - 0.5*ΔA)^{-1}ΔBu_{n+1}
control vector는 작은 Δ 동안 일정하다고 가정함
이를 통해 우리는 이산화된 SSM을 얻을 수 있었음. 이를 명시저ㅗㄱ으로 작성하면
\bar{A}=(I - 0.5ΔA)^{-1}(I + 0.5ΔA) \bar{B}=(I - 0.5*ΔA)^{-1}ΔB \bar{C}=C
x_k=\bar{A}x_{k-1}+\bar{B}u_k u_k=\bar{C}x_k
Convolutive view of an SSM
x_0 = \bar{B}u_0, y_0 = \bar{C}x_0 = \bar{C}\bar{B}u_0 으로 두면 첫번째 식과 두번쨰식을 풀면. 컨볼루젼 커널 \bar{K}_k=(\bar{C}\bar{B}, \bar{C}\bar{A}\bar{B}, …, \bar{C}\bar{A}^k\bar{B}) 를 확인할 수 있음. K * u 로 표현 가능.
이산화 이후 얻어진 \bar{K}를 컨볼루젼 커널이라 함. SSM 컨볼루젼 커널로 일반적으로ㅓ 언급됨. 이는 입력 시퀀스의 전체 크기와 동일함. 이는 FFT(Fast Fourier Transform)으로 계산됨,.
CNN에서 작은 크기의 필터(커널)과 곱셈 연산을 수행하고 그 결과를 합산하여 필터가 커버하는 영역의 특성을 포착함. 이처럼 컨볼루션은 두 함수의 합성으로 한 함수가 다른 함수에 영향을 주는 방식으로 계산되는 수학적 연산임.
이산화 이후 \bar{K} 의 컨볼루젼 커널을 적용할 수 있음. 이 컨볼루젼 커널은 FFT를 통해 계산됨.
Advantages and limitations of each of the three views
컨볼루젼 학습 은 병렬화를 통한 빠른 학습이 가능하고 반복적인 시각은 효율적인 추론이 가능하고 연속적인 시각은 연속적인 데이터를 다룰때 선호합니다.
Figure 3: Image from the paper Combining Recurrent, Convolutional, and Continuous-time Models with Linear State-Space Layers by Albert GU et al, released a week before S4
SSM의 각 시각은 이점과 단점을 가지고있음
continuous view 에서는 자동적으로 연속적인 데이터를 처리할 수 있음. 그리고 수학적으로 분석이 가능함. 정확한 궤적 계산이나 메모리 시스템을 구축함으로써 HiPPO. 그러나 극도로 학습과 인퍼런스가 느림.
recursive view에서는 시계열 데이터에서 자연적으로 발생하는 편향이 생기고 컨텍스트의 unbounedd 원리에 있음. 효율적인 추론이 가능함(constant-time 상태 업데이트). 그러나 학습이 느림(병렬 부족), 그리고 기울기 소식이나 폭발이 학습동안 일어남 너무 긴 시퀀스에서.
convolutional 시각에서는. CNN의 잘알려진 장점과 단점을 이야기함. 지역적으로 interpretable 특징, 효율적인 병렬화. 온라인이나 자기회귀(autoregressive) 컨텍스트에서는 느림(반드시 재계산해야함 전체 입력을 각 새로운 데이터 포인트에서) 그리고 컨텍스트 사이즈가 고정되어있음.
autoregressive: 이전의 데이터를 가지고 다음값을 예측하는 방식 또는 모델을 의미함.
그래서 데이터나 각 절차의 장점에 관련하여 변환이 각각 가능함.
Learning matrices
\bar{C}, \bar{B} 는 학습 가능한 스칼라값임. \bar{A}를 염려에 두면 컨볼루젼 커널에서 볼 수 있다. k 번째에 k 제곱으로 표현된다. 이는 매우 시간이걸리는 계산이고 고정된 \bar{A}를 찾는다. 그래서 최고의 옵션은 대각행렬 A이다. 선형대수에서의 spectral theorem에 따르면 정방 행렬이다.
경험적으로 SSM의 초기화할때 랜덤 A 행렬은 안좋은 결과를 내었다. 반면에 HiPPO 행렬에 기반한 초기화는 좋은 결과를 내었음. 해당 행렬은 정방 행렬은 아니지면 정방행렬에 더하여 저랭크 행렬(NPLR)로 분해된다.
Experimental results
S4의 결과를 설명함.
- 오디오 작업.
컨브넷보다 적은 파라미터로 성능 향상.
- 시계열.
단변량 뿐만 아니라 다변량 설정에서도 유사한 우위
- 비전 작업.
효율성이 강조됨.
- 자연어 처리 작업.
16K 토큰 길이의 Path-X 작업을 최초로 해결함.
S4는 적은 파라미터로도 강력한 성능을 보이며 긴 시퀀스 처리에서 트랜스포머보다 우수한 점이 있음. 연속적인 데이터에서 강점을 보이고 자연어 처리에서는 트랜스포머보다 약점을 보였으나 개선되고 있음. 특히 긴 시쿼스 처리 등에서 트랜스포머 대비 강력한 성능을 보임.
Conclusion
매우 긴 시퀀스를 효과적으로 처리. 트랜스포머나 convnet 보다 적은 수의 파라미터로 우수한 성능 발휘, 연산 속도 빠름.
To dig deeper
S4보다 앞서 LMU(Legendre Memory Unit)이 S4의 전신이라 볼 수 있음. ODE 미분 방정식을 기반으로함.
History of State Space Models (SSM) in 2022
Structured State Space sequence model(S4)은 트랜스포머와 유사하게 시퀀스 데이터를 처리하는 새로운 방식으로 긴 시퀀스 처리 능력과 병렬처리, 변환구조, 등으로 트랜스포머의 혁신적인 접근 방식에 상응하는 새로운 패러다임을 제시함.
S4의 저자는 새로운 HiPPo matrix의 중요성을 포험한 섹션의 논문을 업데이트함. HiPPO 매트릭을 사용한 SSM이 좋은 성능을 보임. 랜덤 dense나 ㅇiagonal 행렬보다.
NPLR(normal plus low rank) 과 HiPPO는 높은 성능의 모델을 얻는데 필수적임.
Diagonal state spaces 위 보다 더 성능이 좋아짐.
그 아래로 다양한 변형들을 보여줌. S4 V2 DSS: Diagonal State Spaces S4D: the diagonal S4 Gated State Space Mega Liquid-S4: Liquid Structural State-Space Models S5: Simplified State Space Layers for Sequence Modeling SGConv
다양한 SSM 모델들을 소개함.SSM이 실제로 응용되기도 했으며 SSM의 컨볼루션적 관점만을 집중적으로 다루는 Hyena 나 SSM의 재귀적인 관점만을 중점적으로 연구하는 Mamba 등이 등장함.
Deep State Space Models for Time Series Forecasting
FP32, FP16, FP8, FP4 MS사에서 FP4로도 비슷한 성능에 관한 논문이 있다고 함.
작성시 목차에 의존하지 말고 내가 직접 생각하면서 정리하기! 만약 목차대로 작성한다면 그냥 “깜지”랑 다를게 없지 않은가?
해당 포스트는 공부를 위해 개인적으로 정리한 내용으로 해당 도서에는 다양한 예시를 통해 좀 더 직관적인 이해가 가능합니다.
ⅠⅡⅢⅣⅤⅥⅦⅧⅨⅩⅪⅫ ⅰⅱⅲⅳⅴⅵⅶⅷⅸⅹⅺⅻ ⒈⒉⒊⒋⒌⒍⒎⒏⒐⒑⒒⒓ ⑴⑵⑶⑷⑸⑹⑺⑻⑼⑽⑾⑿ Α α, Β β, Γ γ, Δ δ, Ε ε, Ζ ζ, Η η, Θ θ, Ι ι, Κ κ, Λ λ, Μ μ, Ν ν, Ξ ξ, Ο ο, Π π, Ρ ρ, Σ σ/ς, Τ τ, Υ υ, Φ φ, Χ χ, Ψ ψ, Ω ω.⋅
Statistics
- 대과목 Course
- 주제 Open Source
- Markdown : marp, Latex, Mermaid Paper
ML
- Graph python
- Guide : PEP
- library : argparse Challenge
- Certificate
- Project DevOps
- OS : linux
- Version Management : git
- Container : Docker, Kube ETC.
- BLOG
- Career
- Book Review
ML 트리에 맞춰서 블로그 포스트 작성 Machine Learning ├── Supervised │ ├── Dimensionality Reduction │ │ └── Linear Discriminant Analysis (LDA) │ ├── Regression │ │ ├── Linear Regression │ │ ├── Multivariate Adaptive Regression Splines (MARS) │ │ ├── K-Nearest Neighbors Regression (KNN) │ │ ├── Random Forest Regression │ │ ├── Decision Tree Regression (CART) │ │ ├── Support Vector Regression (SVR) │ │ └── Locally Weighted Scatterplot Smoothing (LOWESS) │ └── Classification │ ├── Decision Tree Classification (CART) │ ├── Random Forest Classification │ ├── Adaptive Boosting (AdaBoost) │ ├── Gradient Boosted Trees │ ├── Extreme Gradient Boosting (XGBoost) │ ├── K-Nearest Neighbors Classification (KNN) │ ├── Logistic Regression │ ├── Naive Bayes │ └── Support Vector Machines (SVM) ├── Neural Networks │ ├── Generative Adversarial Network │ │ ├── Wasserstein GAN (WGAN) │ │ ├── Cycle GAN │ │ ├── Deep Convolutional GAN (DCGAN) │ │ ├── Conditional GAN (cGAN) │ │ └── Generative Adversarial Network (GAN) │ ├── Autoencoders │ │ ├── Sparse Autoencoder (SAE) │ │ ├── Denoising Autoencoder (DAE) │ │ ├── Variational Autoencoder (VAE) │ │ └── Undercomplete Autoencoder (AE) │ ├── Recurrent Neural Networks │ │ ├── Recurrent Neural Network (RNN) │ │ ├── Long Short Term Memory (LSTM) │ │ └── Gated Recurrent Unit (GRU) │ ├── Feedforward Neural Networks │ │ ├── Deep Feed Forward (DFF) │ │ └── Feed Forward (FF) │ └── Convolutional Neural Networks │ ├── Transposed Convolutional Network │ └── Deep Convolutional Network (DCN) ├── Unsupervised │ ├── Dimensionality Reduction │ │ ├── LLE Embedding (Locally Linear Embedding) │ │ ├── t-SNE (t-Distributed Stochastic Neighbor Embedding) │ │ ├── UMAP (Uniform Manifold Approximation and Projection) │ │ ├── PCA (Principal Component Analysis) │ │ ├── MDS (Multidimensional Scaling) │ └── Clustering │ ├── K-Means │ ├── Gaussian Mixture Models (GMM) │ ├── Hierarchical Agglomerative Clustering (HAC) │ └── DBSCAN (Density-Based Spatial Clustering of Applications with Noise) ├── Reinforcement │ ├── Value Based Method │ │ ├── SARSA (State-Action-Reward-State-Action) │ │ ├── Q-Learning │ │ └── Deep Q Neural Network (DQN) │ └── Policy Based Method │ ├── Policy Gradient (REINFORCE) │ └── Proximal Policy Optimization (PPO) ├── Semi-Supervised │ ├── Label Spreading │ ├── Self Training Classifier │ └── Label Propagation └── Other └── Probabilistic Graphical Models └── Bayesian Belief Networks (BBN)
출처 : https://towardsdatascience.com/denoising-autoencoders-dae-how-to-use-neural-networks-to-clean-up-your-data-cd9c19bc6915
. REFERENCES
- temp
- temp
- temp
- temp