[Paper]SAM2
SAM에 이어 Meta FAIR에서 만든 실시간 비디오 처리를 위해 SAM2는 실시간 비디오 처리를 위한 연속 메모리(Streaming-Memory)를 지닌 간단한 트랜스포머 아키텍처인 SAM2를 소개하겠습니다.
Ⅰ. SAM2
Segment Anything Model 2는 비디오와 이미지 세그멘테이션의 통합된 모델입니다. 해당 모델은 Promptable Visual Segmentation(PVS) task로 이미지 세그멘테이션을 비디오 도메인으로 일반화 하는 것이 목표로 단일 이미지 그리고 비디오 프레임 사이에서 관심있는 물체의 마스크의 세그멘테이션을 수행합니다.
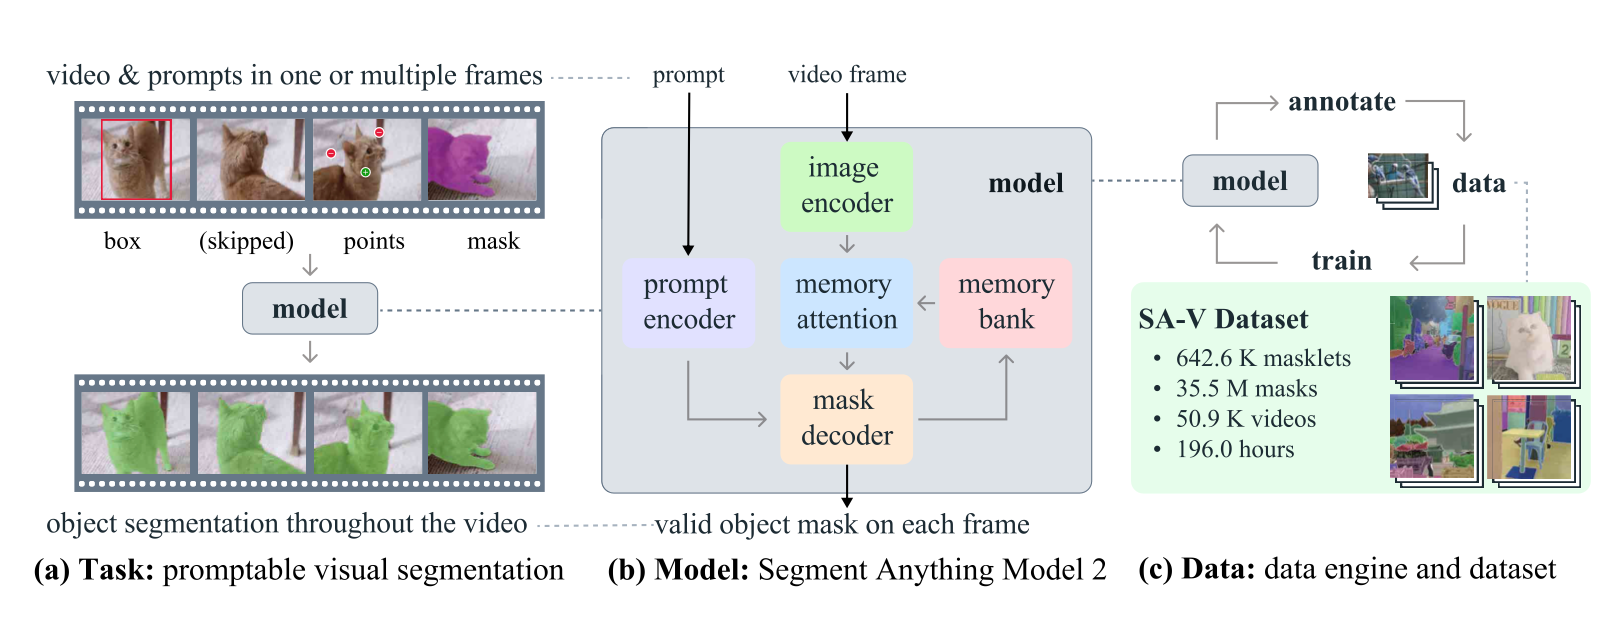 Figure 1 : SAM2 Model; 단순히 현재 프레임의 정보만이 아니라 이전 상호작용에 관한 정보를 저장하는 메모리를 활용함.
이러한 SAM2는 아직 특정한 어려움을 마주치진 못했지만, 붐비는 씬이나 작은 변화 사이에서 세그멘트가 실패하면 물체를 혼동하거나 잃어버릴 수 있다고 합니다.
ⅰ. Details of the PVS Task
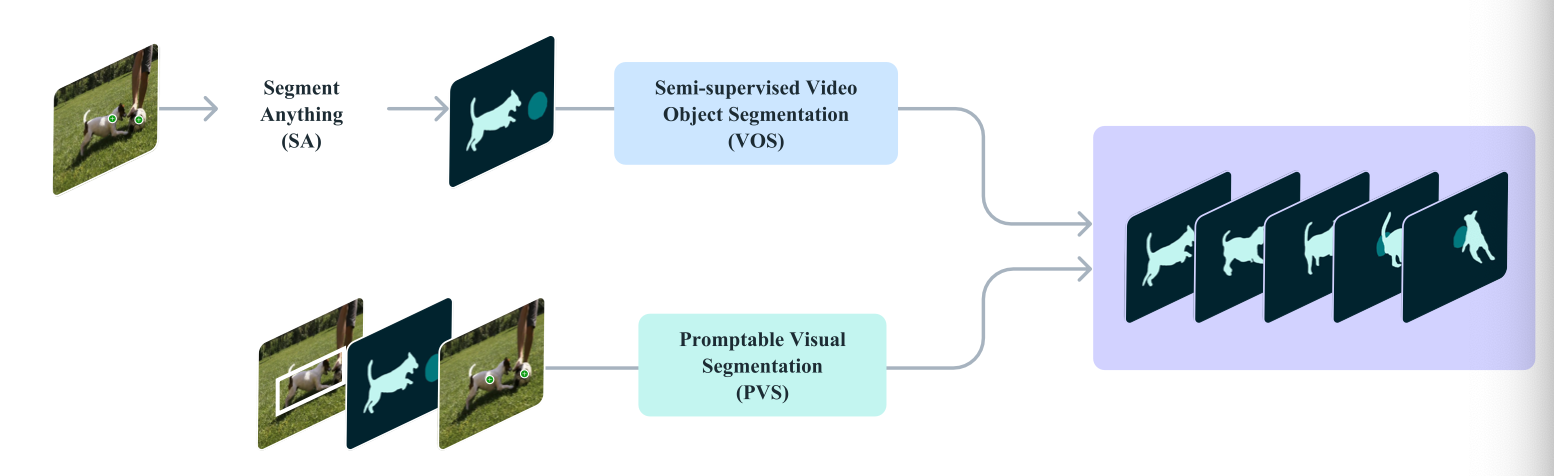 Figure : PVS Task
위의 PVS에 관한 일러스트를 보면, VOS는 PVS의 특정한 사례로 볼 수 있습니다. PVS에서는 프롬프트로 클릭, 마스크, 박스, 포커스를 활용하며 이를 통해 상호작용 경험을 강화할 수 있습니다. 또한, 최소한의 사용자 개입만으로도 세그멘테이션의 정교한 개선이 가능합니다.
Ⅱ. Task: promptable visual segmentation
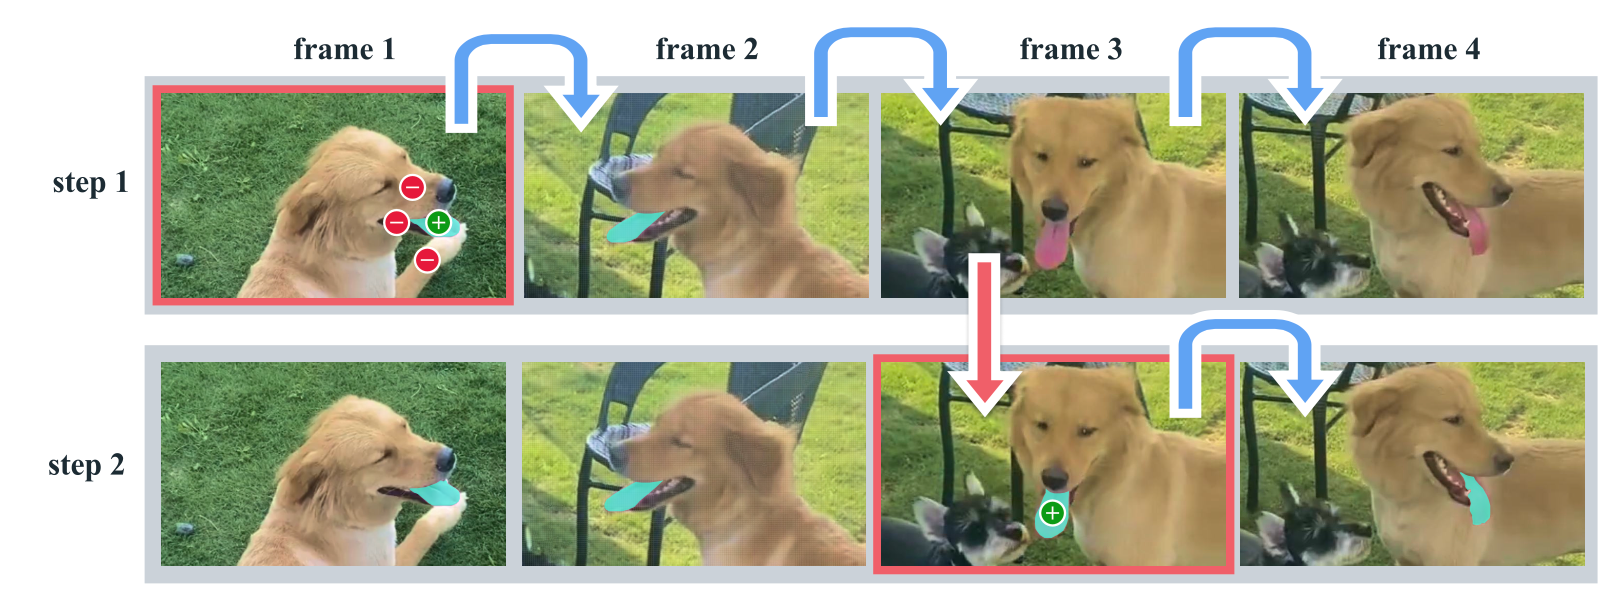 Figure 2 : Interactive segmentation with SAM2
해당 모델의 프롬프트는 Positive/Negative clikcs, boxes, mask 등 으로 제공됩니다. 위 그림에서 Step 1(selection) 단계에서는 파란색 절차로 진행이 되고, 객체를 잃어버린 경우 빨간색 방향으로 masklet을 수정합니다. 그 뒤 Step 2(refinement) 단계를 통해 한번의 클릭을 통해 객체를 복구하여 알맞은 masklet을 얻습니다.
Ⅲ. Model
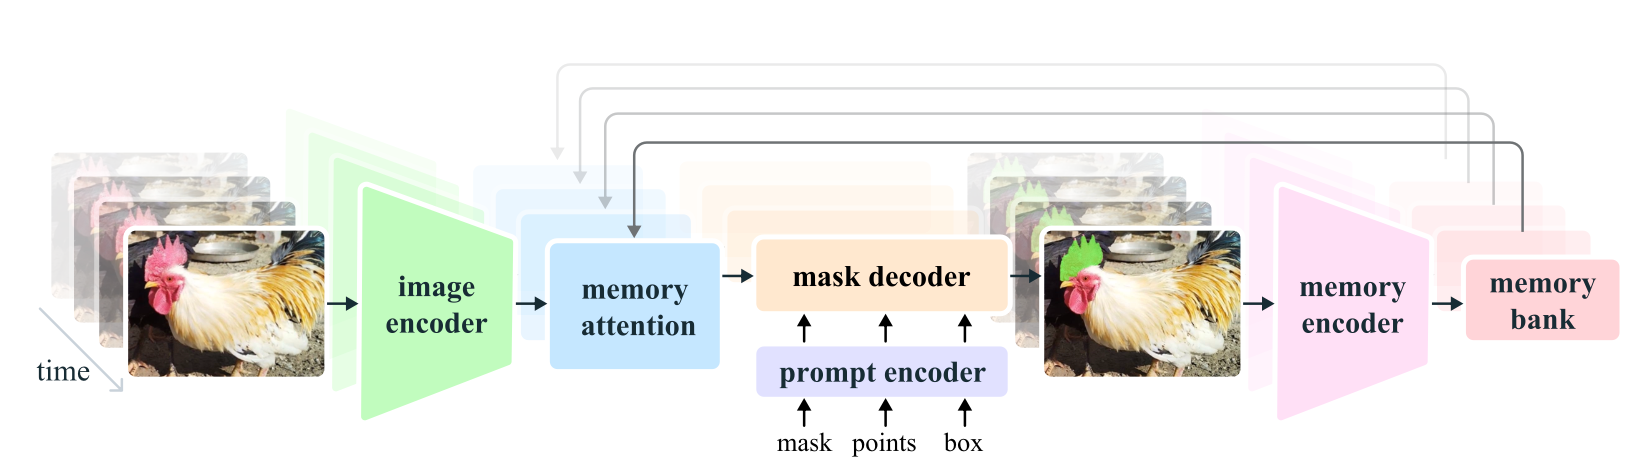 Figure 3 : SAM2 Architecture; 프레임이 주어지면 세그멘테이션 예측은 현재 프롬프트 그리고/또는 이전 관찰된 메모리의 조건적으로 수행됩니다. 비디오는 스트리밍 방식(들어오는 대로 순차적으로)으로 처리 됩니다.
이전 SAM과 동일하게 점, 박스, 마스크 프롬프트들은 각 프레임에서 개별적으로 정의됩니다. 하지만, SAM2 디코더에 사용되는 프레임 임베딩은 바로 이미지 인코더로 전달되지 않고, 과거의 예측과 프롬프트화된 프레임의 메모리에 조건적으로 입력됩니다. 해당 모델은 이미지와 비디오 데이터에서 결합적으로 학습이 진행되었습니다.
이미지 인코더긴 비디오를 실시간으로 처리하기 위해 스트리밍 방식으로 전체 상호작용 동안 한 번만 작용하며 각 프레임을 표현하는 비 조건적 특징 임베딩(토큰)을 제공합니다. 해당 인코더는 “feature pyramid network”를 사용하고, global 어텐션을 이미지 인코더 레이어의 일부에서만 사용했다고 했습니다.
메모리 어텐션메모리 어텐션의 역할은 현재 프레임의 특징을 과거 프레임 특징 위에서 조건화하는 것으로 새로운 프롬프트를 예측하는 것입니다. 현재 프레임의 이미지 인코딩을 입력으로 받아 여러 트랜스포머 블록을 거치게 됩니다. 차례대로 셀프 어텐션, 크로스 어텐션(프롬프트, 비프롬프트, 오브젝트 포인터 메모리)을 진행하고, MLP를 통해 바닐라 어텐션 방식으로 셀프-,크로스-어텐션을 수행합니다.
프롬프트 인코더와 마스크 디코더프롬프트 인코더는 기존 SAM과 동일하게 동작하며 sparse한 프롬프트는 포지셔널 인코딩으로 표현된 후 더해지게 됩니다. 디코더 또한 SAM을 따르며 “two-way” 트랜스포머 블록을 통해 프롬프트와 프레임 임베딩을 함께 업데이트합니다.
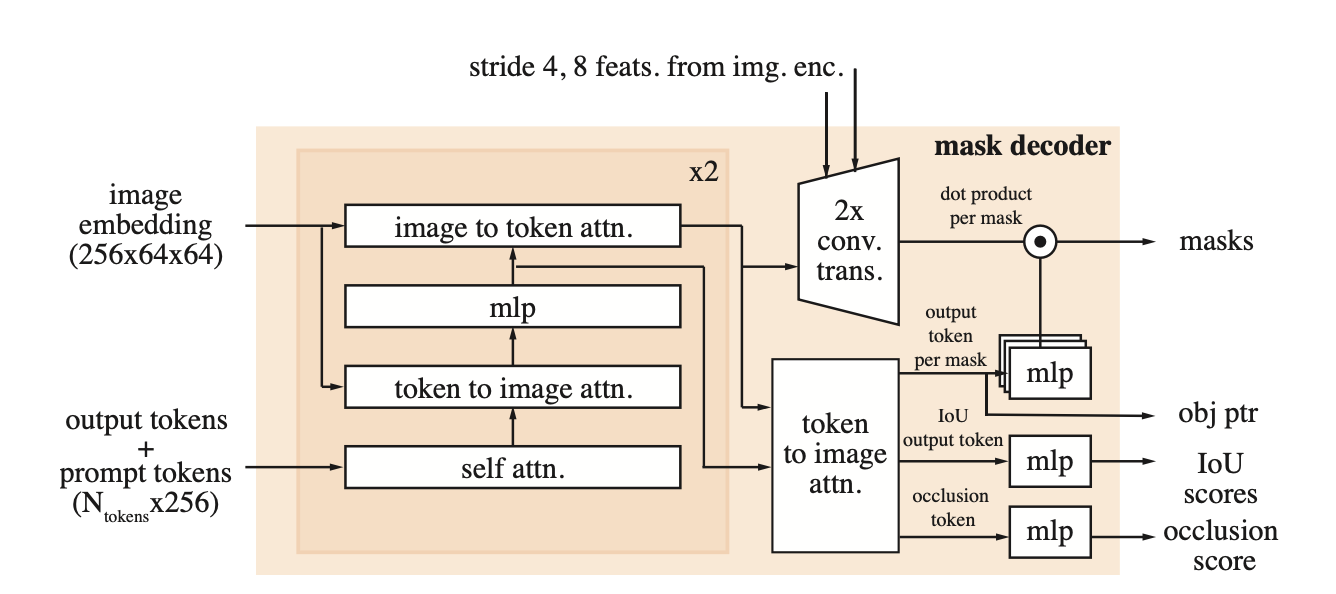 Figure 11 : Mask Decoder; 이미지 인코딩에서 stride 4, 8 특징을 업샘플링 시 사용합니다. 마스크 토큰을 물체 포인터로 사용하고, 물체가 가려진 정도인 occlusion 스코어를 생성합니다.
메모리 인코더메모리 인코더는 마스크 디코더에서 나온 마스크를 컨볼루젼 모듈을 사용해 다운샘플링한 후 이미지 인코더에서 나온 비조건적 프레임 임베딩과 “element-wise”로 합산합니다. 이를 light-weight 컨볼루젼 레이어를 적용하여 융합합니다.
메모리 뱅크메모리 뱅크는 과거 정보를 FIFO 큐 방식으로 저장됩니다. 세그멘테이션 특징인 공간 특징 맵(spatial feature)으로, 물체 포인터인 light-weight vector는 고차원의 의미(semantic) 정보를 담은 리스트로 저장됩니다.
Ⅳ. Data
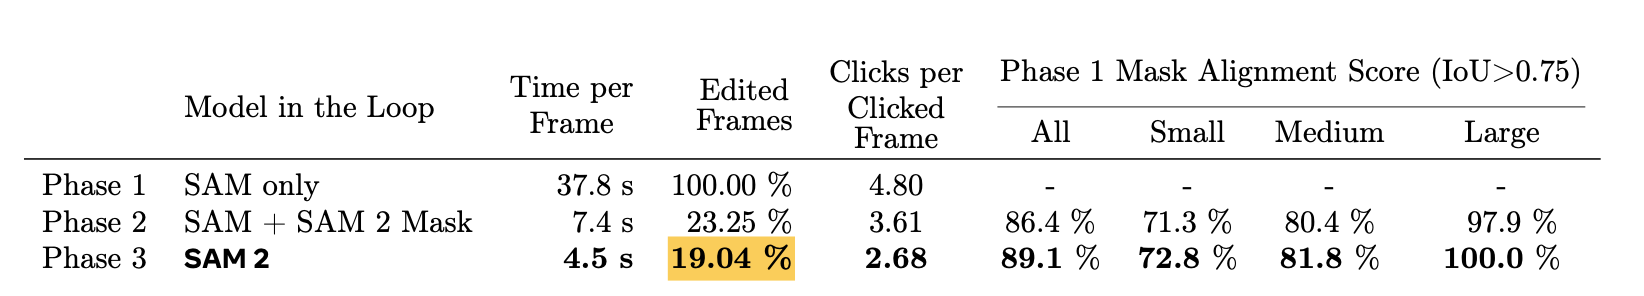 Figure 4 : Data Engine Phase
- Phase 1 : SAM per frame. 초기 작업으로 SAM을 사용함.
- Phase 2 : SAM2를 loop에 넣음.
- Phase 3 : 완전 특징화된 SAM2를 활용함.
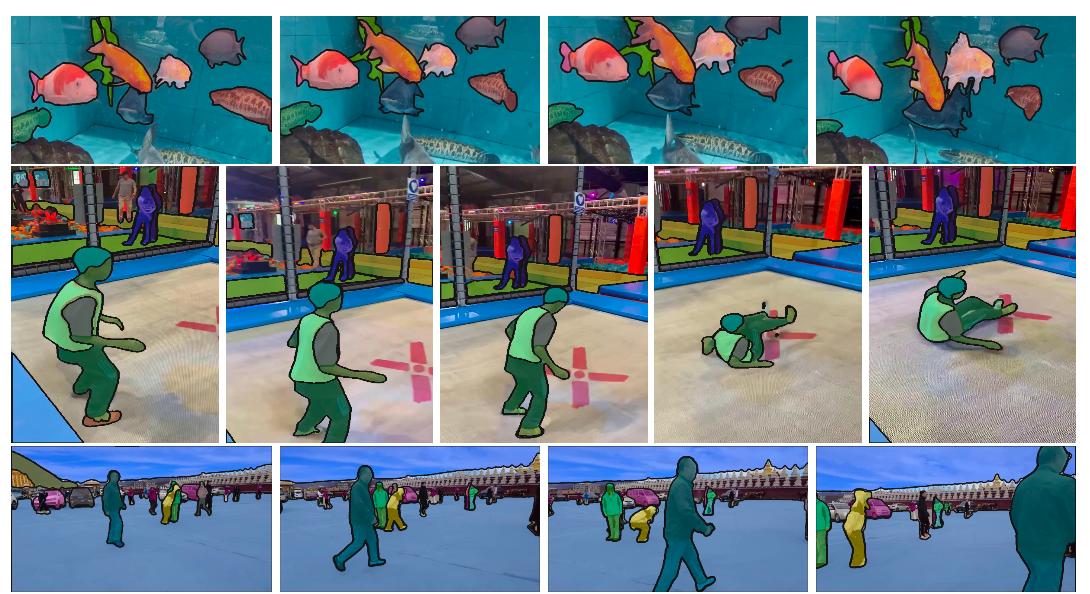 Figure 5 : SA-V Dataset.
해당 데이터셋은 SAM2를 위해 구성되었으며, 50.9K 개의 비디오와 masklet, 190.9K 개의 수동 masklet 어노테이션, 그리고 451.7K 개의 자동 생성된 masklet을 포함합니다.
Ⅴ. Zero-shot Experiment.
VOS를 평가하는 지표인 J&F metric으로 비디오를 그리고 mIoU로 이미지 태스크를 평가하였습니다.
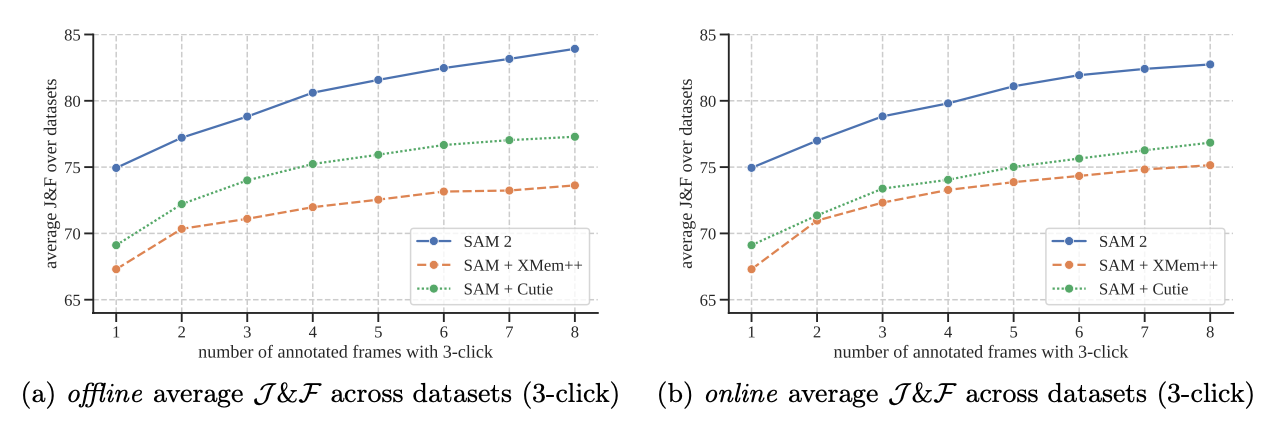 Figure 12 : Zero-shot accuracy over 9 datasets in interactive offline and online evaluation settings.; (좌) 오프라인 (우) 온라인
처음으로 Promptable video segmentation에 대해 평가하였습니다. 두 가지 설정을 사용하여 오프라인 환경에서는 비디오의 여러 단계에 걸쳐 프레임을 선택하는 방식을 선택하고, 다른 온라인 평가에서는 단일 전방 패스를 통해 프레임에 주석을 다는 방식을 사용하였습니다.
해당 결과를 통해 SAM2는 두 가지 환경에서 모두 좋은 성느을 보여 주었고, 종합적으로 3배 더 작은 상호작용과 함께 높은 정확도를 보여 주었습니다.
이후 semi-supervised VOS 환경에서의 평가와 37개의 제로샷 이미지 세그멘테이션 데이터셋에서 평가한 결과 비대화형(non-interactive) 작업과 더 불어 이미지 세그멘테이션 작업에서도 더 좋은 결과를 보여 주었습니다. 이처러 SAM2가 이전 모델보다 6배 더 빠른 이유로 효과적인 Hiera 이미지 인코더 덕분이라고 하였습니다.
Ⅵ. Comparison on Semi-supervised VOS
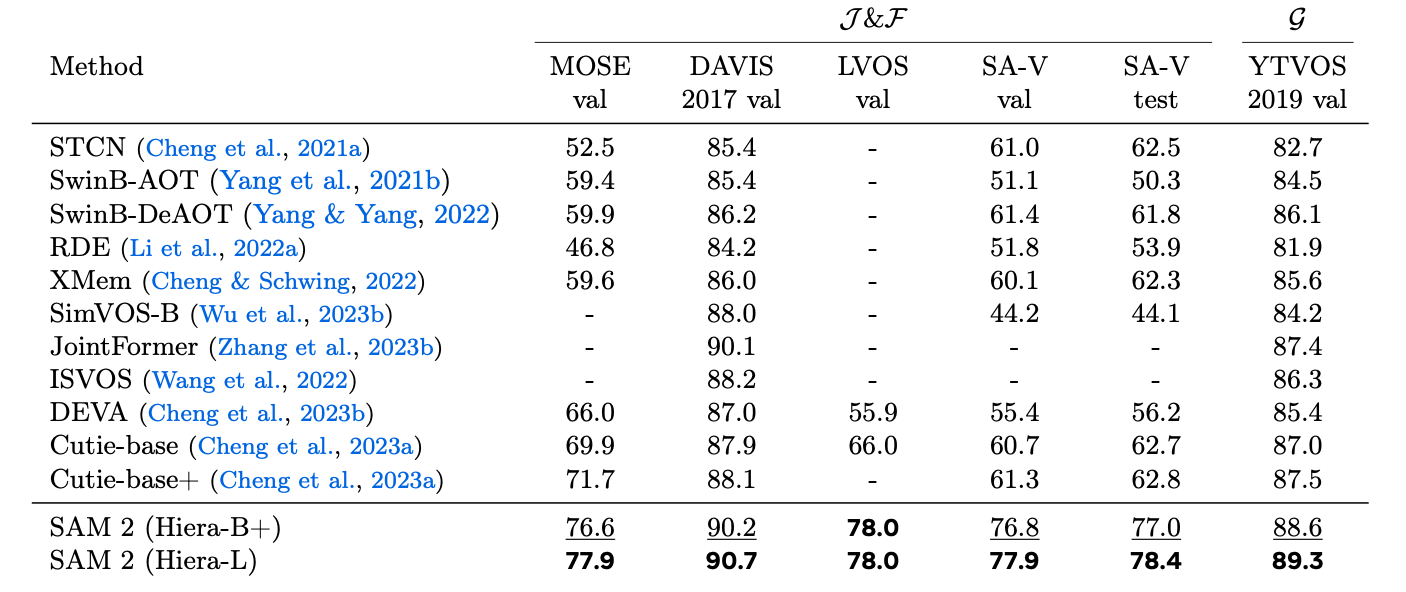 Figure 13 : Comparison with SOTA
SAM2는 주로 일반화에 중점을 두었지만, 특정한 semi-supervised VOS 환경도 함께 다루었습니다. 위 그림에서 SOTA와의 비교 결과를 보면, 대형 이미지 인코더를 사용하는 것이 다양한 영역(Board)들에서 상당한 정확도 향상이 나타났음을 암시합니다.
또한, SA-V의 검증 및 테스트 셋에서 평가를 진행해 오픈월드 세그멘테이션에서 어떠한(Any) 물체 클래스에 대해서도 성능 측정이 가능했습니다. 결과적으로, SAM2는 장시간 비디오 물체 세그멘테이션에서 의미 있는 성능 향상을 보였습니다.
Ⅶ. Ablation Study
해당 논문에서는 모델 아키텍쳐 설계에 관한 연구 또한 소개하였습니다. 해당 결과를 통해 LLM과 같은 대규모의 데이터의 역할을 엿볼 수 있었습니다.
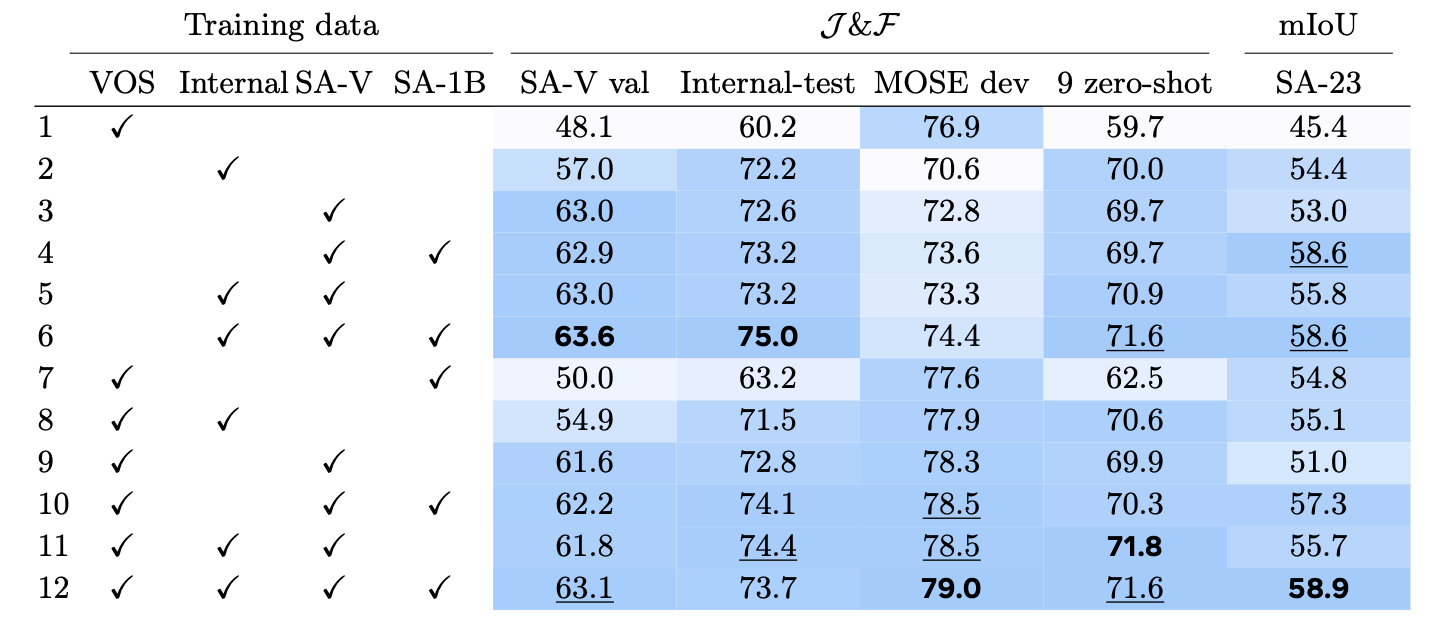 Figure : data mix ablation; VOS, SA-1B, and our data engine data; 모든 데이터를 섞어 학습한 경우가 성능이 좋음.
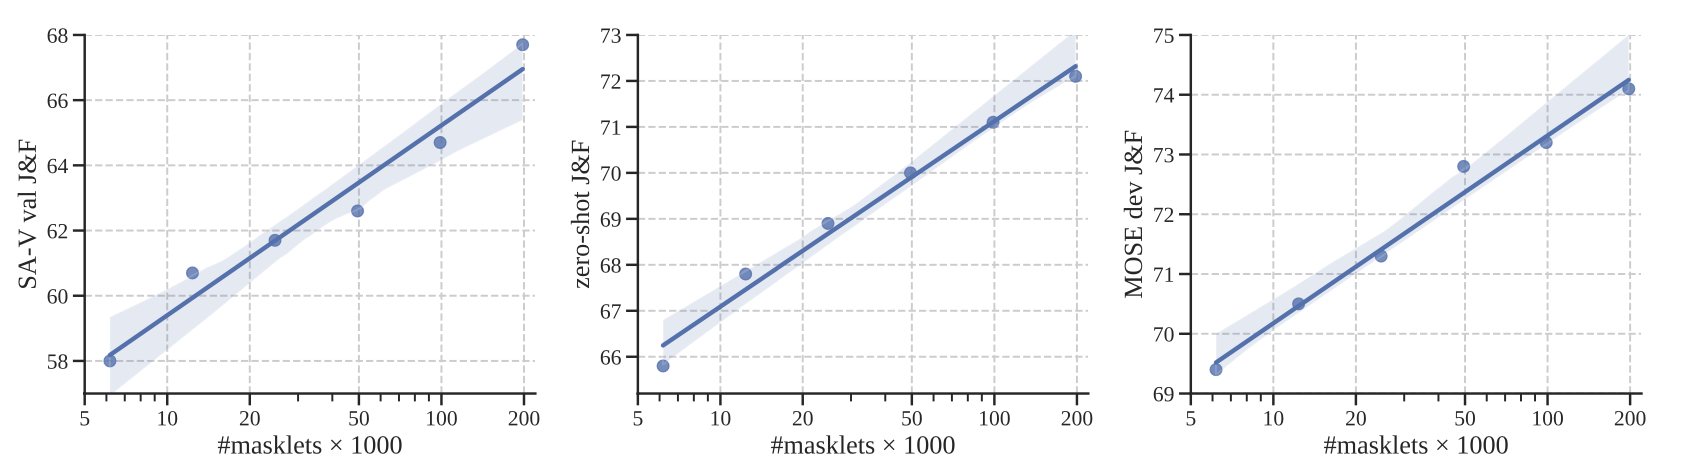 Figure : Data Quantity ablation; 학습 데이터의 스케일링에 관한 연구를 진행하였으며 학습 데이터의 quantity와 비디오 세그멘테이션 정확도 사이의 관계가 지속적으로 증가함을 보였음.
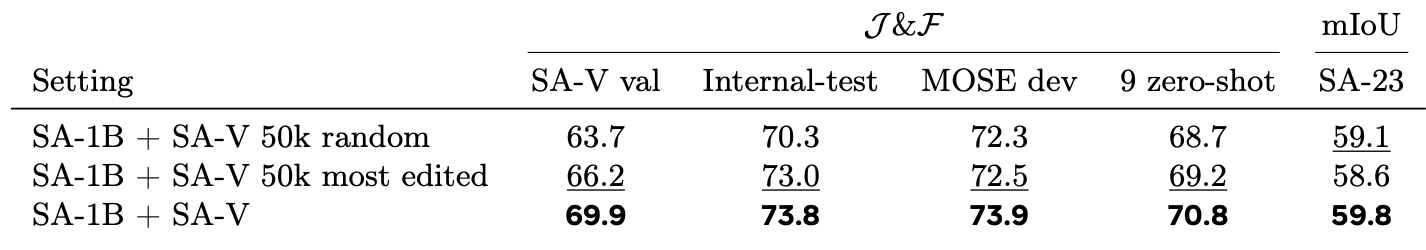 Figure : data quality ablation; 퀄리티에 관한 실험으로 25%의 데이터만 무작위로 작업한거나 가장 많이 수정된 데이터 들만 가지고도 좋은 성능이 나오긴 했지만 전체 데이터를 쓰는게 더 나음을 보여줌. 즉, 특정 품질이 좋은 데이터만 쓰는 것보다 전체 데이터를 쓰는게 더 낫다.
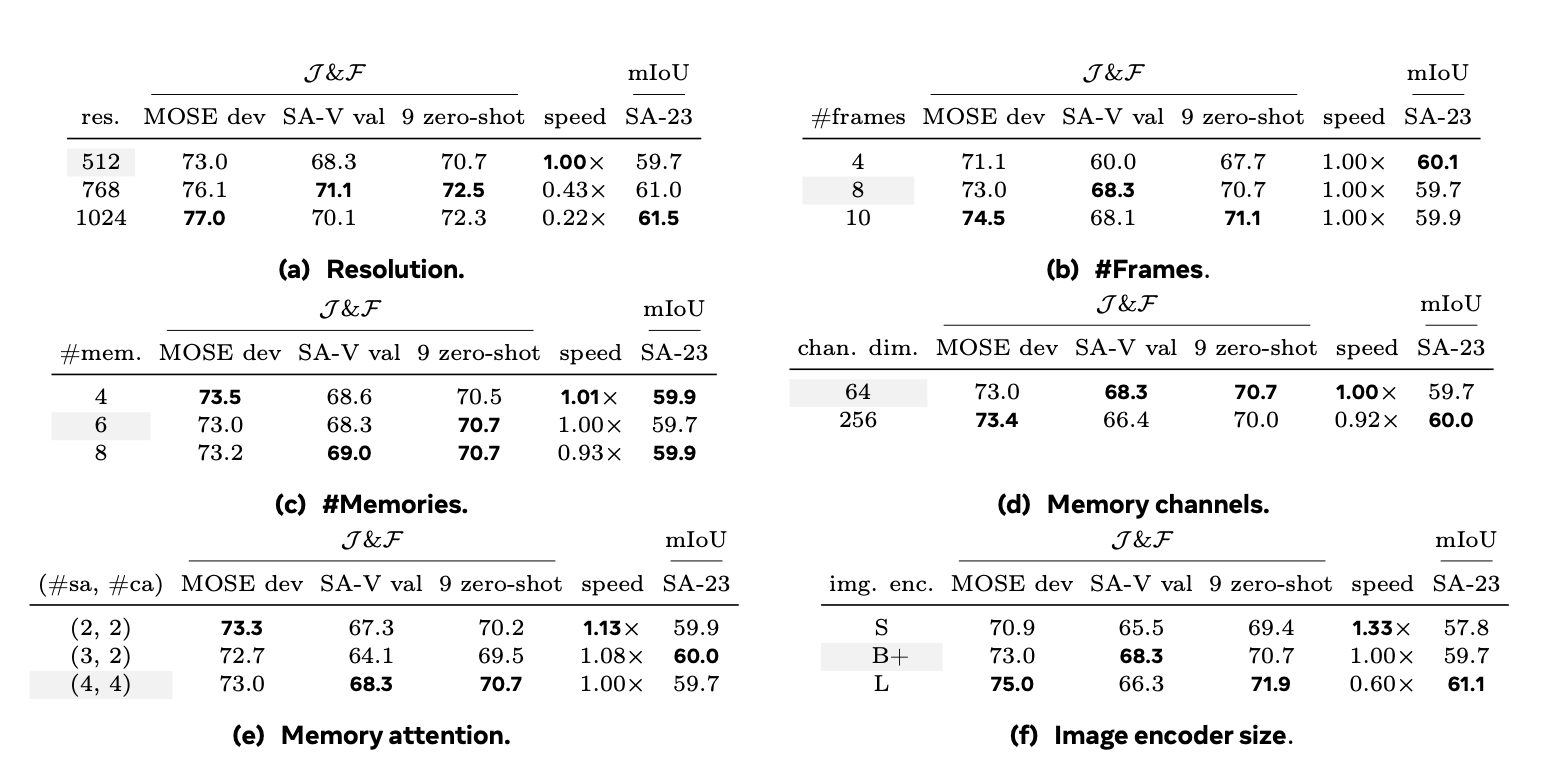 Figure : 모델 아키텍처 ablations
Capacity: 입력 사이즈, 프레임 증가 및 해상도의 향상은 이미지와 비디오에서 의미있는 성능 향상을 이끌어냄.메모리 사이즈: 메모리 수 의 증가는 일반적으로 성능 향상에 도움이 되지만 약간의 변동이 있으며 더 많은 채널을 사용하는 것은 성능 회귀에 원인이 되지 않음.모델 사이즈: 이미지 인코더나 메모리 어텐션의 더 많은 capacity는 향상된 결과를 보여줌.
ⅰ. Positional Encoding
절대(Absolute) 포지셔널 인코딩(각 픽셀에 고유한 좌표를 부여하는 방법)을 각 이미지 인코더와 메모리 어텐션에 사용하였습니다. 글로벌 어텐션 레이어에서 RPB(Relative positional biases)를 적용하면 속도가 향상되었으나 이미지 인코더에서 RPB를 제거 하는 것이 성능 저하 없이 속도를 향상 시키는 것으로 나타났습니다. 반면, 메모리 어텐션에서는 2D RePE를 유지하는 것이 이점을 제공했습니다.
ⅱ. Memory Architecture
재귀 메모리메모리 특징을 GRU를 통해 메모리 뱅크에 저장하기 전에 전달하는 방식의 효과를 조사한 결과 이러한 접근 방식은 성능 향상을 불러오진 않았지만
충분한 메모리 특징을 직접적으로 메모리 뱅크에 저장되는 것이 더 간단하고 효과적인 방법임을 확인했습니다.오브젝트 포인터물체 포인터 벡터를 사용하여 다른 프레임 마스크 디코더 출력과 cross-attention하는 영향을 실험한 결과 성능 향상이 없었습니다. 따라서,
물체 포인터를 직접적으로 메모리 인코더에서 메모리 뱅크 임베딩과 함께 활용하는 방식이 보다 적절한 접근법이라 하였습니다.
Ⅷ. REFERENCES
- Meta Segment Anything Model 2 for videos and images
- 2024, “SAM 2: Segment Anything in Images and Videos”, Meta FAIR