[Paper]MoCo
MoCo(Momentum Contrast for Unsupervised Visual Representation Learning)는 2020년에 Facebook AI Research 팀에서 발표한 논문으로 기존의 고차원 공간인 CV 분야에서도 대조적 학습의 한계를 극복하였습니다.
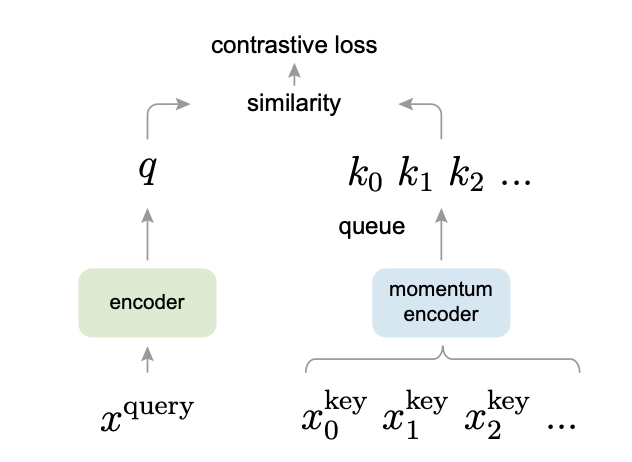 Figure 1 : Momentum Contrast
Ⅰ. Introduction
언어 작업은 이산적인 신호 공간에서 진행되지만 컴퓨터 비전 작업은 연속적이고 고차원적인 공간에서 구성됩니다. 최근 대조적 학습을 활용한 방법들은 일종의 동적 사전(dynamic dictionary)으로 볼 수 있습니다. 여기서 사전의 키(key)는 데이터에서 샘플링되며, 인코더 네트워크를 통해 표현됩니다. 비지도 학습에서는 인코더가 사전을 활용하여, 인코딩된 쿼리(query)가 올바른 키와는 유사하고, 다른 키들과는 비유사하도록 학습됩니다.
이 과정에서 사전을 만들때는 우선 1. 커야하고 2. 학습동안 일관되어야 한다고 가정했습니다. 직관적으로, 큰 사전은 연속적이고 고차원적인 시각 공간에서 더 잘 샘플링 될 것입니다. 그러나 현재의 loss는 한 두가지 측면에서 제약이 있습니다.
MoCo는 크고 연속적인 사전을 만드는 방법을 소개합니다. 데이터 샘플의 queue로서 사전을 유지하고, 현재의 미니 배치의 인코딩된 표현은 큐에 넣고 오래된 것은 빠지게 됩니다. 사전의 키는 몇몇의 미니 배치들에서 천천히 업데이트되는 Momentum Encoder를 통해 생성됩니다.
따라서, 모코 매커니즘은 대조적 학습을 위한 동적 사전을 구성할 수 있습니다. 비지도 학습의 목적은 표현을 사전학습하는 것으로 모코는 실세계에서 더 잘 적용할 수 있으며 수십억 개의 이미지 스케일이나 비정제된 데이터에서도 적용이 가능합니다.
Ⅱ. Method
ⅰ. Contrastive Learning as Dictionary Look-up
대조적 학습은 사전(dictionary)의 look-up 작업을 위한 인코더를 학습하는 것으로 생각할 수 있습니다. 인코딩된 쿼리 q와 인코딩된 샘플 키 k 들이 존재한다고 가정하고, q에 매칭되는 양성 k가 하나만 존재한다고 가정하면 대조적 손실 함수는 q가 매칭되는 k와 가까울때 작아야하므로 아래와 같습니다.(τ는 temperature 하이퍼 파라미터)
InfoNCE Loss
\[L_q = -log\frac{exp(q\cdot k_+/τ)}{\sum^K_{i=0}exp(q\cdot k_i/τ)}\]이러한 InfoNCE는 양성 샘플과 음성 샘플간의 차이를 인식할 수 있는 임베딩 공간을 학습하는 것으로 비지도학습 목적 함수로써 인코더 네트워크가 쿼리와 키의 표현을 학습하기위해 전달됩니다.
ⅱ. Momentum Contrast
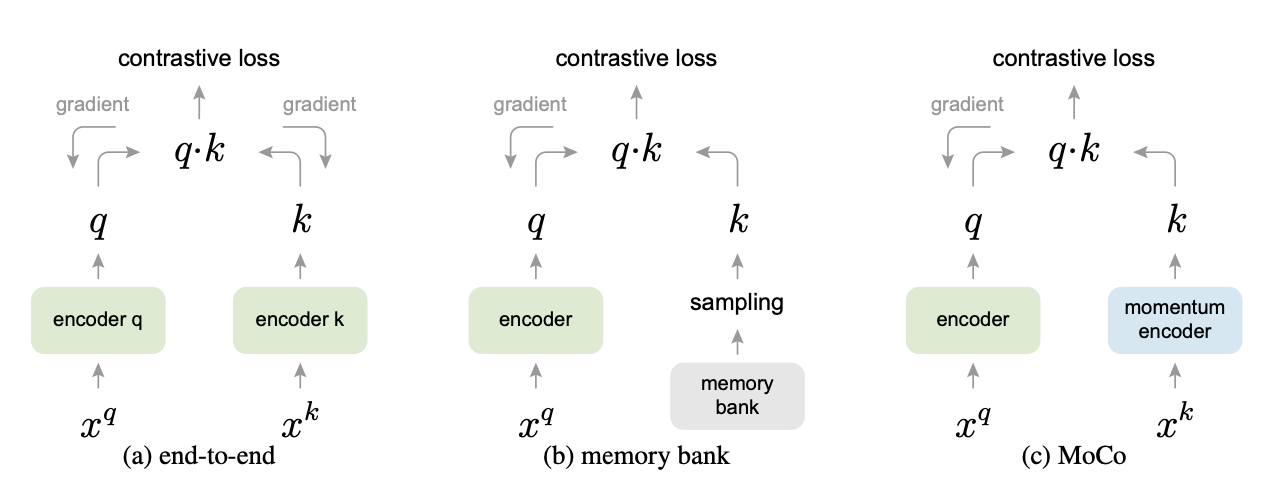 Figure 2 : Comparison of three contrastive loss mechanism
Dictionary as a Dynamic Queue
사전(dictionary)은 동적으로 구성된 키(key)의 집합으로, 임의로 샘플링된 데이터 샘플들로 이루어집니다. 좋은 표현 학습은 큰 사전을 통해 이루어질 가능성이 높습니다.
Dictionary as a Queue
이 접근법의 핵심은 데이터 샘플을 큐(queue)로 구성하는 것입니다. 이전 미니배치에서 인코딩된 키들을 큐에 저장하여 재사용함으로써, 사전의 크기를 전형적인 미니배치 크기보다 훨씬 크게 유지할 수 있습니다.
이 큐는 항상 데이터의 샘플링된 부분집합을 표현하므로, 메모리 효율성을 유지하면서 더 큰 사전을 제공합니다.
ⅲ. Momentum update
큐를 사용하면 더 큰 사전을 유지할 수 있지만, 큐에 포함된 키 인코더를 업데이트하기 어려워집니다. 단순한 해결책으로, 쿼리 인코더로부터 키 인코더를 복사하여 그래디언트를 무시할 수 있지만 실험 결과로 좋지 않은 성능이 나오는 것을 볼 수 있었습니다. 이는 키 인코더의 빠른 변화가 키 표현의 일관성을 떨어뜨리는 결과를 초래하기 떄문이라고 가정했습니다.
따라서, 아래와 같이 모멘텀 계수 m을 사용하여 파라미터 \(θ_q\)만 역전파를 통해 업데이트 됩니다.
\[θ_k \Leftarrow mθ_k + (1-m)θ_{q\cdot}, m \in [0,1]\]이러한 결과로 이전 미니배치의 키 인코더로 큐의 키들이 인코딩 되지만, 인코더들 간의 차이는 작아져 큐에 포함된 키들의 표현이 더 일관성 있어집니다.
ⅳ. Relations to previous mechanism
기존의 end-to-end 업데이트 방식은 현재 미니배치에서만 수행되어 GPU 메모리 제약이 있습니다. 그리고 메모리 뱅크 접근법은 데이터셋의 모든 샘플 표현을 저장하여 사용합니다. 이는 저장된 샘플 표현은 마지막으로 업데이트 된 시점의 표현으로 업데이트 되고, 여러 키 샘플들은 여러 단계에 걸쳐 서로 다른 인코더로부터 인코딩 되므로, 표현이 덜 일관됩니다.
모코는 모든 데이터 샘플을 추적하지 않으므로 모멘텀 업데이트가 적합하지 않은 데이터셋에서도 사용가능합니다. 또한, 메모리 효율적이며 수십억 개의 대규모 데이터에서 학습이 가능합니다.
이후에 Pretext Task에서 BN(Batch Normalization)을 활용하여 학습하였더니 모델이 low-loss 해결법을 쉽게 찾는 일종의 “cheat”를 사용하여 shuffling BN을 사용하여 해결하였습니다.
ⅴ. Intuition
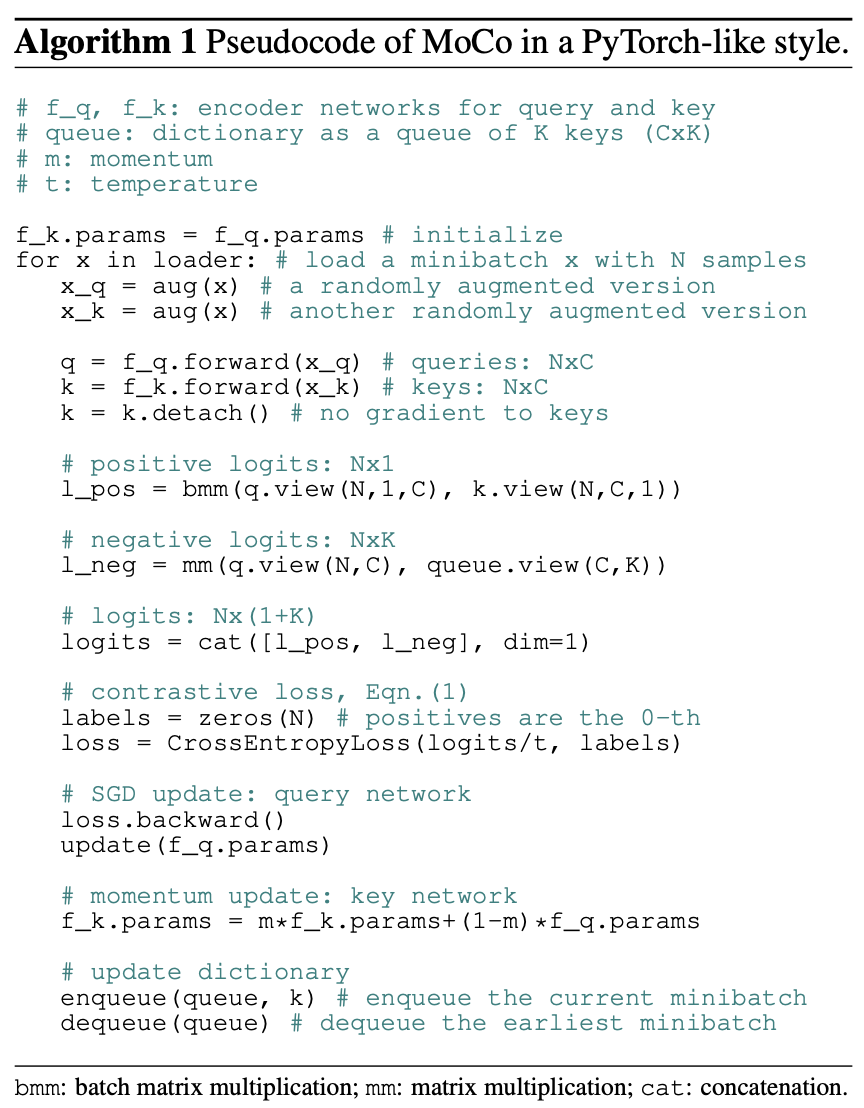 Figure 3 : Pseudocode of MoCo
즉, 같은 데이터가 쿼리와 키로 들어가 인코딩되고 인코딩 된 키의 값을 큐에 넣어 큐에 네거티브 샘플을 많이 가질 수 있도록 하고, 해당 큐와 쿼리를 통해 손실 함수를 계산하여 역전파를 통해 쿼리 인코더를 업데이트 한 후에 모멘텀 업데이트를 통해 키의 인코더를 업데이트 하는 방법입니다.
Ⅲ. Experiments
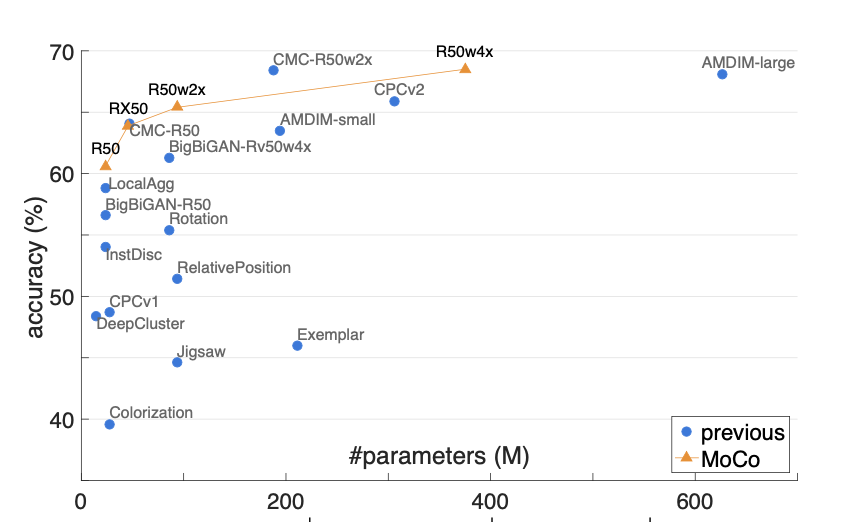 Figure 4 : Comparison under the linear classification protocol on ImageNet
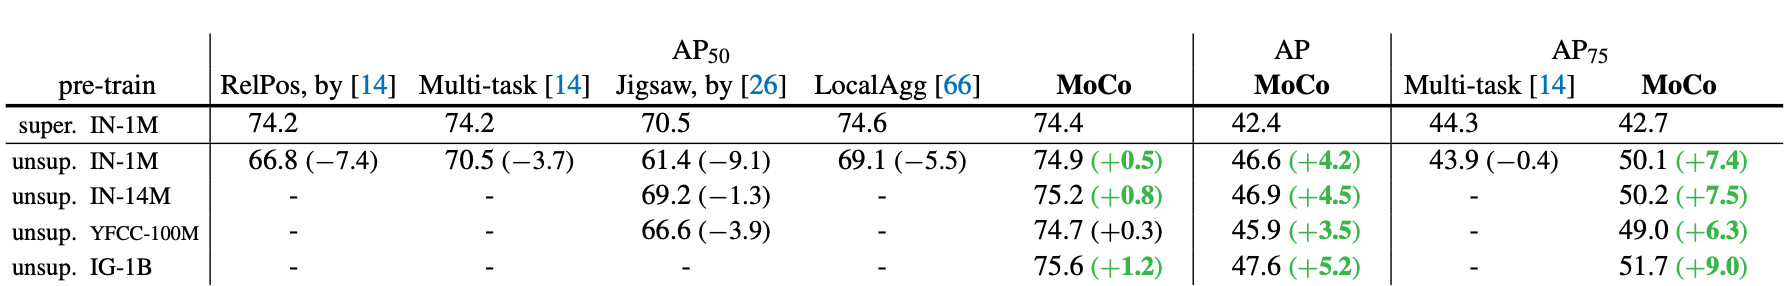 Figure 5 : Comparison with previous methods on object detection fine-tuned on PASCAL VOC
Ⅳ. REFERENCES