[Paper]BYOL
2020년에 DeepMind에서 발표한 ‘Bootstrap Your Own Latent A New Approach to Self-Supervised Learning’(BYOL) 논문입니다.
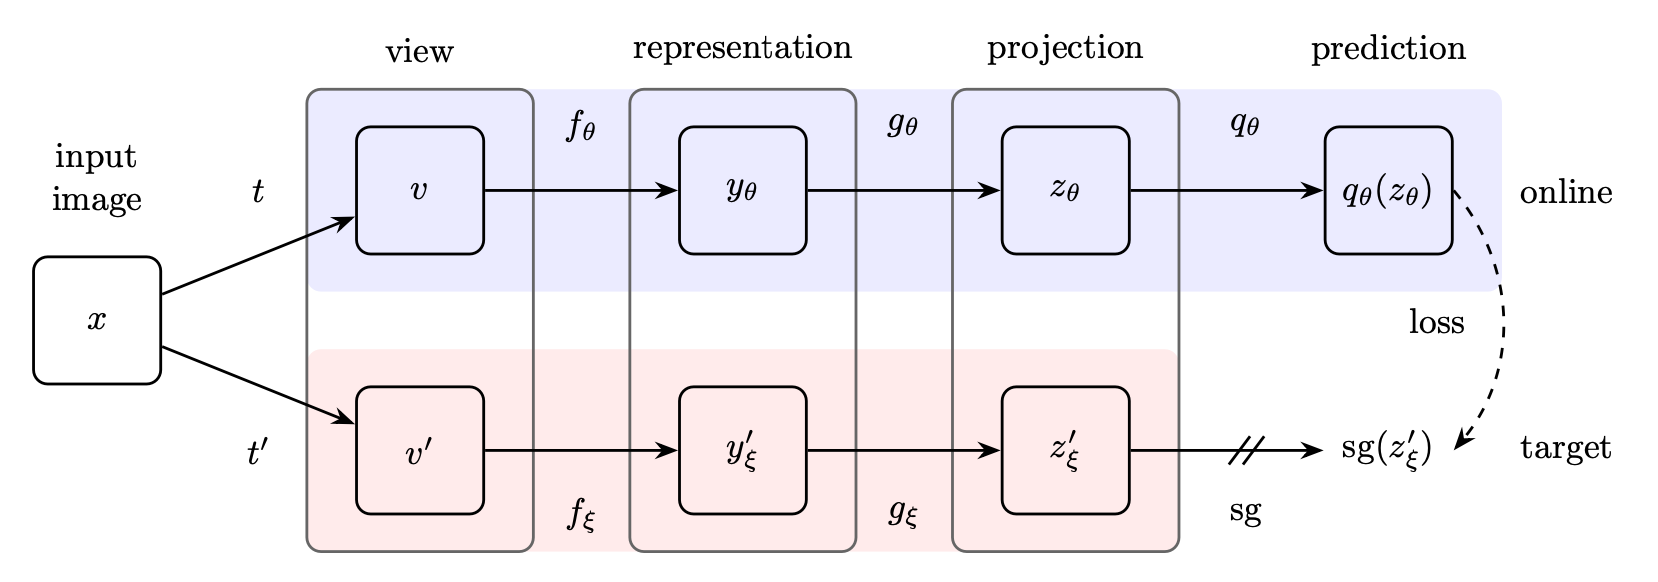 Figure 1 : Overview of BYOL architecture
Ⅰ. introduction
해당 논문은 self-supervised 이미지 표현 학습의 새로운 방법으로 ‘online’과 ‘target’의 두 가지 네트워크를 사용합니다.
이전의 대조 방법들 사이에서는 같은 이미지(positive pairs)의 다르게 종합된 시각의 표현 사이의 거리를 줄이는 방법과 다른 이미지(negative pairs)들의 종합된 시각의 표현 사이의 거리를 늘리는 방식으로 학습되어 왔습니다. 그러나 해당 방법은 negative pairs 없이 대조 방법의 SOTA 보다 더 높은 성능을 달성했습니다.
이는 반복적인 bootstrap으로 네트워크의 출력을 강화된 표현의 목표로서 전달합니다. 또한, 대조적 방법들보다 이미지 증강 선택에 대해 더 견고한 성능을 보입니다. 해당 방법은 모든 이미지에서 똑같은 벡터를 내놓는 붕괴된 해법인 ‘Collapsed solution’(i.e. 표현을 학습하지 못하고 수렴하는 상태)를 허용하지만 실험적으로 수렴하지 않음을 확인했습니다. 여기서 온라인 네트워크에 예측자를 추가하는 것과 온라인 파라미터의 이동평균을 타겟 네트워크로 사용하는 것의 조합이 온라인투영 내에서 더 많은 정보를 인코딩하게 하여 붕괴된 해법을 피하는 데 중요한 역할을 한다고 가정했습니다.
Ⅱ. Method
표현 공간에서 예측을 직접적으로 하는 것은 collapsed representation로 이끈다고 합니다. 예를 들어, 변함없는 시각의 표현은 항상 스스로 완전히 예측될 수 있습니다. 대조적 방법은 예측 문제를 재공식화함으로서 이 문제를 회피합니다.
대조적 방법은 다른 이미지나 같은 이미지에서 다르게 종합된 시각의 표현들 사이에서의 판별력을 학습합니다. 대부분의 경우, 이는 학습이 붕괴된 표현을 찾는 것을 방지합니다.
하지만 이 판별법은 전형적으로 종합된 시각의 각 표현을 비교하는 것을 요구하며 많은 음성 예제들이 필요합니다. 따라서, 해당 논문에서는 네거티브 예제가 필수적인지 아닌지를, 붕괴를 예방하기 위해 고성능을 보존하는 방법으로 밝혀냈습니다.
붕괴를 막기 위한 단순한 방법은 고정된 임의로 초기화된 네트워크를 사용하여 우리의 예측을 목표로 실행하는 것입니다. 이렇게 하면 붕괴를 피할 수 있지만, 경험적으로 이것이 좋은 표현을 얻는 방법은 아닙니다. 그럼에도 불구하고 이 절차를 사용하여 얻은 표현은 초기의 고정된 표현보다 더 우수하다는 점에서 의미가 있습니다.
주어진 표현에서 새로운 잠재적으로 강화된 표현을 학습하는 과정은, 목표로 언급된 표현을 온라인 네트워크에서 반복적으로 학습하여 강화된 표현을 생성하는 시퀀스를 만들도록 합니다. 이후 온라인 네트워크는 새로운 목표 네트워크로 사용됩니다.
경험적으로 BYOL은 bootstrapping 절차를 일반화한 것으로, 표현을 반복적으로 refining(세분화)하는 방식입니다. 그러나 온라인 네트워크의 느린 지수 이동 평균(EMA)을 사용하는 것은 목표 네트워크에 고정된 체크포인트를 대신하는 역할을 합니다.
ⅰ. Description of BYOL
해당 네트워크의 목표는 다운스트림 작업에 사용되는 표현을 학습하는 것으로 ‘online’과 ‘target’ 두 가지 네트워크를 사용하여 학습합니다. ‘online’ 네트워크는 인코더 \(f_{\theta}\), 투영기 \(g_{\theta}\), 예측기 \(q_{\theta}\)의 세 가지 단계로 구성됩니다. 목표 네트워크 또한 온라인 네트워크와 같으며 다른 가중치를 사용합니다.
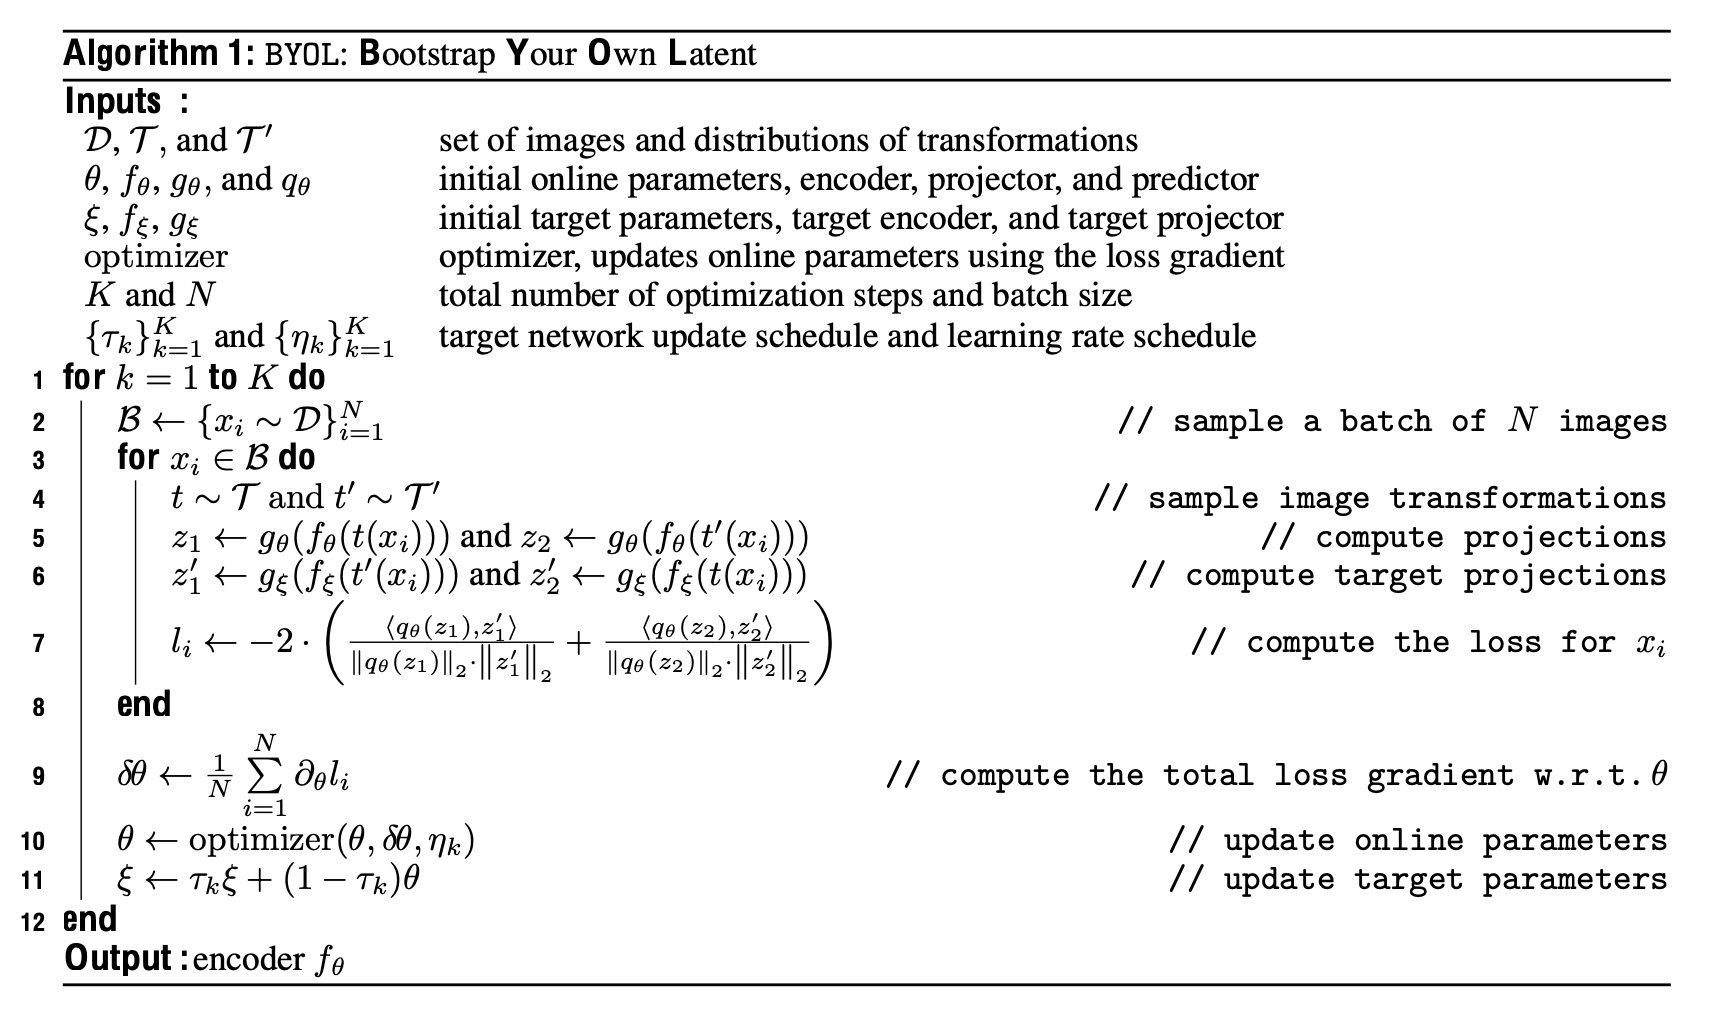 Figure 2 : BYOL Algorithm
두 가지 view(v, v’)에서 위의 단계를 거친 값들에서 L2 정규화 후 나온 두 값(\(\bar{q_θ}(z_θ)\), \(\bar{z}'_ξ\))들에 대하여 계산하면 아래와 같은 MSE 손실 함수를 구할 수 있습니다.
\[\begin{align} L_{θ,ξ} &= \Vert \bar{q_θ}(z_θ) - \bar{z}'_ξ \Vert^2_2 \\ &= \Vert \bar{q_θ}(z_θ) \Vert^2_2 + \Vert \bar{z}'_ξ \Vert^2_2 -2\cdot \frac{⟨ q_θ(z_θ), z'_ξ ⟩}{\Vert q_θ(z_θ) \Vert_2 \cdot \Vert z'_ξ\Vert_2}\\ &= 2 - 2 \cdot ⟨ q_θ(z_θ), z'_ξ ⟩ \end{align}\]여기서 symmetric loss function를 사용하여 v’를 온라인 네트워크의 입력으로 하여 \(L_{θ,ξ}\)와 v를 목표 네트워크의 입력으로 하여 \(\tilde{L}_{θ,ξ}\)를 대칭화합니다. 따라서 최종 손실 함수는 아래와 같습니다.
각 네트워크의 가중치 업데이트는 아래와 같이 이루어집니다.
\[θ \leftarrow \text{optimizer}(θ, \nabla_θ L^{BYOL}_{θ,ξ}, η) \\ ξ \leftarrow τξ + (1 - τ)θ, τ ∈[0,1]\]목표 네트워크는 회귀 목표를 온라인 네트워크를 학습하기 위해서. 그리고 그것의 파라미터 ξ는 온라인 파라미터 θ의 지수 이동평균이다. 여기서 sg(stop-gradient)를 사용하여 타겟 네트워크의 가중치가 업데이트 되지 않도록 함.
ⅱ. Intuitions on BYOL’s behavior
붕괴를 막는 명시적인 항은 존재하지 않지만 ξ가 θ의 기울기를 따라 업데이트 되지 않아 \(L^{BYOL}\)이 공동의 손실함수(i.e. GAN과 비교하여)가 없기에 항상 최소값으로 수렴한다는 사전 이유가 존재하지 않습니다.
Ⅲ. Bootstrapping
기본적인 부트스트랩의 의미는 여러 샘플을 뽑아 통계적인 추정을 하는 방법으로 해당 논문에서 사용한 ‘Bootstrapping’의 의미는 잠재 표현을 부트스트랩(i.e. 지수이동평균(EMA)를 사용하는 것을 의미)하여 진행하는 것입니다.
목표 네트워크의 투영된 표현을 사용하고, 이 네트워크의 가중치는 온라인 네트워크의 가중치의 지수 이동 평균으로 계산됩니다. 이러한 방법은 목표 네트워크의 가중치가 온라인 네트워크보다 지연되고 안정적인 가중치를 지니게 합니다.
Ⅳ. Conclusion
- SSL의 새로운 알고리즘을 제안.
- Target, Online 네트워크 구조.
- Negative pairs 없이 학습 가능.
- Contrastive Learning 방식 외에도 효과적인 방법을 제안함.
Ⅴ. REFERENCES