[BOOK]독서 노트(5)
우연히 접하게 된 스티븐 스티글러의 도서를 보면서 ‘통계학의 역사’,’확률에 대한 철학적 시론’, ‘통계학을 떠받치는 일곱가지 기둥이야기’ 등의 도서를 접하게 되어 통계학을 배웠던 사람으로써 수식만 배웠지 그 원리와 배경은 잘 몰라 흥미가 돋아 보게 되었습니다. 해당 도서들은 차례대로 ‘1986’, ‘1999’, ‘2016’ 순으로 통계학의 발달 과정과 확률과 통계의 개념의 철학적 토대 그리고 현대 통계학의 핵심 개념으로 정리가 됩니다.
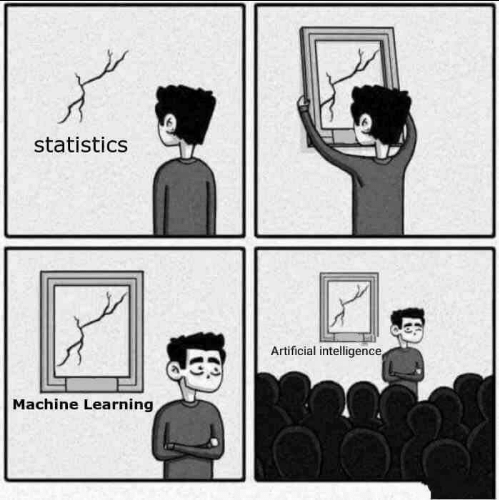 Figure 1 : 인터넷에 떠돌던 밈
사실 교양과도 가까운 이 도서들을 읽으면서 ‘이건 기초도 아닌데?’라는 생각에 그만 읽을까 생각했었습니다. 계속해서 새로운 기술이 나오는 지금 ‘현대의 지식을 탐하기도 바쁜데 자꾸 뒤를 바라보는 것이 맞나?’ 라고 문득 떠올랐지만 이게 습관으로 굳어지지 않게 경계하면서 이따금 둘러보는 건 좋을 행동이지 않을까 합니다.
Ⅰ. 통계학의 역사
통계 관련 도서라기 보다는 거의 역사학에 가까운 도서였지만 생각보다 흥미로운 책이었습니다. 통계학에서 기본적으로 사용하던 원리들이 어떻게 나오게 된 맥락들을 알게 되었고, 발전하는 과정에서의 사고를 엿볼 수 있어 대단함을 느꼈습니다. 해당 도서는 통계가 발전하는 과정의 실패와 번뇌 그리고 어떻게 영향을 미쳤는지 상세하게 기술되어 있어 더 어렵게 느껴졌던 것 같습니다.
“궁극적으로 분석해보면 모든 지식은 역사학이다, 추상적으로 보면 모든 과학은 수학이다, 근본 원리를 따져보면 모든 판단은 통계학이다.”
확률의 역사는 철학적인 측면에서 대단한 4중 성공담이 존재합니다. 형이상학에서 우연과 필연의 문제를 설명하며 인식론에서는 확률을 통해 증거와 신뢰도를 설계하고, 논리학에서 공리를 이용하기도 하지만 통계적 추론을 활용하고, 윤리학에서는 합리적 선택을 할 수 있도록 했습니다.
통계학은 “The measurement of uncertainty“로 검은 베일에 쌓인 불확실성의 영역을 탐색하여 결국에는 이성으로 지배해보려는 야심찬 시도를 추적하는 과정을 소개했습니다. 저자가 해당 도서를 통해 학문의 성격을 되돌아 보는 기회를 가질 수 있다고 하였는데, 그 말의 의미가 느껴졌던 도서였습니다.
통계는 수학이라는 범주 안에 들어가 있긴 하지만 정형화된 답을내놓는 수학과 다르게 '불확실의 과학'이라고도 합니다.
오늘날의 통계학은 경험과학을 위해 하나의 계량적인 기법을 제공합니다. 이러한 통계학은 불확정성을 측정 하기위한 논리와 방법론이며 실험을 관찰, 계획하고 해석하는 과정에서 불확정성 때문에 생기는 결과들을 살펴 보기위한 논리와 방법으로 인도합니다.
이는 20세기에 들어서야 비로소 독립된 학문으로 인정받게 되었습니다. 통계학의 역사는 모든 과학의 역사를 넘나들어야 마땅한데, 해당 도서는 다른 과학에서 비롯되다가 학문으로 정립돠기 이전인 1900년 이전에 이루어진 것들로서 그 시초와 발달사만 다룹니다.
현대 통계학은 단순한 도구상자가 아니며 개별 과학에서 쓰는 관계없는 기법들을 잡다하게 모아 놓은게 아니라 그러한 것들을 넘어서는 그 이상의 것입니다. 통계적 방법들간에는 통일성이 있이게 어느 분야에서도 함께 쓸 수 있습니다. 통일성은 결코 피상적인 것이 아니며 분야에 따라 결과에 대한 해석은 다를 수 있지만 해석에 동원되는 그 개념과 논리적 결과 및 한계는 거의 같습니다. 통일된 논리 체계는 하나의 근원에서 비롯한 것이 아니라 여러 잡다한 것에서 나온 통일성이고 잡다함이 눈에 띄어 우리를 혼란스럽게 만들었습니다.
1. 최소제곱법과 관측 결과들의 결합
18세기 마이어의 천문학 연구에서 시작하여 여러 관측 방정식을 결합하는 아이디어가 서서히 발달하였고, 보스코비치의 측지학 연구에서 객관적인 기준('관측값과의 오차 합이 최소가 되어야 한다')을 써서 관측 결과와 식의 차이를 알아본다는 아이디어가 생겨났습니다. 이 두 결과에서 영감을 종합한 것은 르장드르가 최소제곱법을 소개함으로써 시작되었습니다. 여기에 확률을 정식으로 이용한 경우는 없었는데, 유도해낸 추정 결과가 포함하는 불확정성을 양적으로 나타내 보이려는 시도가 없었습니다.
2. 확률을 연구한 사람들과 불확정성의 측정
이후 관측값의 불확실성을 계량적으로 다루려는 시도가 시작되었습니다. 1713년에 야콥 베르누이의 저서 ‘추측술’을 통해 수학적 확실성과 물리적 확실성보다 낮은 수준의 "개연적 확실성(probable certainty)"을 얻으려면 너무 큰 횟수의 시도가 필요하게 되어 “가장 어리석은 사람은 관측을 더 많이하면 찾는 목표에서 비껴나 헤맬 위험이 줄어든다고 믿는다”라고 말하며 더 발전시키지는 못하였지만 관측 자료에 내재된 불확실성을 정량화하려는 노력이 있었습니다.
이후 드 무아브르는 해석학적 기법을 도입하여 이항분포의 정규 근사를 발표함으로써, 시행 횟수 n이 증가함에 따라 기댓값에 “확률적”으로 가까워 진다는 것을 알렸습니다. 이렇게 질적이고 직관적인 판단에서 계량적인 판단으로 옮겨가는 단계는 중요한 단계로 베르누이가 시도하였으나 실패하고 드 무아브르가 해석학적 기법으로 성공하였습니다.
드 무아브르는 해당 결과의 중요성을 “비록 우연에서 불규칙성이 생기기는 하지만 불규칙성이 자연적으로 신의 뜻에 따라 생기는 질서가 시간이 지나는 과정에서 되풀이해서 나타나는 데에는 아무런 역할도 하지 못하게 될 승산은 무한히 클 것이다”라고 이야기 했습니다.
3. 역확률
라플라스가 확률과 통계에 관심을 가지게 된 주요 동기 중 하나는 서로 모순되는 데이터를 조화롭게 일치시키는 방법을 찾는 것으로 “관측값이 다 다를때, 진짜 값을 어떻게 찾는가?”이 질문으로 시작하여 드 무아브르가 봉착한 문제를 풀어가기 위한 주된 핵심이 되었습니다.
해석학자인 라플라스는 1774년 “사건 원인의 확률에 대한 논문”에서 역확률 개념을 정리하여 “결과로부터 원인을 추론하는 방식’으로 발전하게 되었는데, 이와 같은 역추론의 개념적인 발달을 가져올 수 있었던 것은 천문 관측 문제를 다루는 것으로 부터 시작하였습니다.
천문학에서는 관찰값의 분포보다 오차의 분포를 분석하는 것이 더 자연스러웠으며 심프슨은 관측 결과들 자체보다는 관측의 오차들에 초점을 맞춤으로써 이 단계가 추론에 있어서 베이스의 외로운 노력을 고무했을 것이라고 했습니다. 심프슨은 오차의 분포를 다루는 과정에서, 그 분포가 주어졌을때 최적 평균값이 될 후보로 산술 평균과 중위수를 제시하였습니다.
이후 라플라스가 더욱 체계적으로 발전시켜 오차 분포를 설명하는 함수로 "라플라스 분포"를 도출하였으며 더 나아가 1810년에는 드 무아브르가 제시했던 정규근사 이론을 일반화하여 “중심극한정리”를 발표하였습니다.
여담으로 저자는 라플라스의 저서의 설명 방식이 수학적 기호 없이 글로만 설명되었다는 점이 철학적, 실용적 관점에서 확률을 설명하려 했기에 이해하기 어렵다고 했습니다.
4. 가우스와 라플라스의 종합
아직 최소제곱법과 확률의 관계에 대한 연구가 다루어지지 않았었습니다. 이 상태에서는 최소제곱 방법으로 얻은 결과의 정확도를 평가하기는 불가능했고, 좋은 결과가 나온다고 할 수는 있지만 관측 결과의 확률적 성질에 대해 언급하지 않고는 불확정성을 양적으로 나타내는 일에서는 답할 수가 없었습니다.
1809년 가우스는 천체의 관측값을 분석하는 과정에서 확률 이론을 최소제곱법과 결합하는 방법을 제시했습니다. 라플라스는 오차곡선이 가져야 하는 가정에서 시작해 오차곡선을 연역한 반면, 가우스는 오차곡선이 가지는 가정을 결론으로 삼아 이 가정을 만족시키는 곡선이 무엇인지 접근했습니다. 그래서 오차곡선으로 정규분포곡선을 제안해 이를 가우스 함수라고도 합니다.
이후 라플라스는 해당 논문을 읽고 최소제곱법과 극한정리 간에 관계를 정리했습니다. 오차들의 합이 중심극한정리에 따라 가우스 곡선이 근사하다는 성질을 갖는다는 것을 밝히고 최소제곱 추정량이 사후 오차의 기대치를 최소로 만든다고 결론지었습니다.
이를 1811년에 더 정교화해서 “미지수에 대한 추정값 가운데 관측한 결과의 일차 함수로 표현되는 것은 근사적으로 정규분포를 따르고, 이런 추정값들 중에서만 생각한다면 최소제곱 방법으로 구한 추정치는 오차의 기대치를 가장 작게 만드는 추정값이다.”라고 발표하였습니다.
5. 케틀레의 두 가지 시도
위의 연구결과들을 사회과학에 적용하기 위해 처음 시도했던 사람은 아돌프 케틀레 였습니다. 그는 벨기에의 출생률과 사망률을 구하여 총인구를 추정하려했지만 표본추출결과는 전수조사와 큰 차이를 보였고, 이에 대해 케버바흐는 “불완전하고 확실하지도 않은 것만 가지고 실존하는 이 모든 요소들을 다 합한 결과를 알아내는 일은 매우 어려워 모든 요소들이 갖는 속성과 수 들의 가능한 모든 경우의 수는 무한대로 많아질 것“이라는 비판을 하였습니다.
그럼에도 불구하고 케틀레는 사회과학 데이터 분석에 "평균적인 사람"이라는 개념을 도입한 것과 "확률모형의 도입"이라는 두 가지 중요한 진보를 만들어 냈습니다.
첫번째인 평균적인 사람이라는 개념은 “관찰 대상이 되는 사람 수가 많아질수록 육체적인 것이든 도덕적인 것이든 관계없이 개인적인 특징들은 사라지고 대신 보편적인 사실들이 지배적으로 두드러져 보이는데 이 때문에 사회가 존재하고 유지된다.” 라는 원리로 개별적 차이를 넘어 전체의 보편적 경향을 파악하는 기반을 마련하였습니다. 그러나 이러한 접근은 앞선 케버바흐의 지적과 같이 무수히 많은 원인들에 대해서 같아질 수는 없어 한계가 있었습니다.
두번쨰로 당시 사회과학에 확률을 적용하는 데 전반적인 의문이 제기되었기에, 케틀레의 연구에서 엄밀하게 확률론을 적용하지 않았습니다. 반면, 1837년 실험물리학자인 푸아송은 확률론을 적용해 판결율의 불확정성에 대해 논하였습니다. 이는 데이터를 보는 관점이 케틀레와 다르게 실험 상황에서의 통제로 고려해야하는 요인이 적다는 생각으로 달랐기에 가능한 일이었습니다. 즉, 푸아송은 좀 더 객관적인 개체에 초점을 맞추고 있었습니다.
또한, 콩트는 확률은 기본적으로 법칙이 아니라 비결정론적인 성격이 이유로 비판하였으며, 1843년 쿠르노는 ‘우연과 확률 이론에 대한 해설’에서 “사회과학에서의 데이터를 분류하는 방법이 무수히 많이 존재하는데 이렇게 분류하다보면 우연에 의해 적어도 한 번 어떤 분류 기준에 의해서 데이터가 큰 차이를 나타내는 경우가 존재한다”는 비판적인 입장을 보였습니다.
이는 케버바흐와 달리, 동질적인 것을 억지로 동일시하여 분석하는 접근법에 대한 반대의견으로 지나친 세분화가 오히려 비동질성을 초래함을 지적한 것입니다.
이렇게 통계적 방법을 사회적 방법으로 확장하여 적용하려 했을때 핵심은 ‘데이터를 얼마나 세분화하여 동질적인 집단으로 만드는 가’와 ‘과도한 세분화로 인해 발생하는 선택 효과를 어떻게 해결할 것인가’에 있었습니다. 여기서 데이터의 변동이 중요한 요인들에 의한 것이라면 해당 데이터를 동질적인 집단으로 취급할 수 없겠지만, 변동들을 무시할 만큼 큰 데이터를 모아 불확정성을 양적으로 나타내지 않고도 분석하는 방법 또는 집단의 동질성을 내부적으로 파악하는 방법을 찾는 것으로 해결이 가능합니다.
여기서 케틀레는 확률 모형을 통해 분석을 합리화하려 했습니다. 그는 데이터를 적절히 잘 분류하고 나누면 개별적으로 중요하지 않은 요인들로 우연 의한 변동만 남게 되고, 라플라스의 정리에 따라 그 집단 내의 분포는 근사적으로 정규분포가 될 것이라고 보았습니다. 즉, 잘 분류된 데이터에서 반드시 나타나기 마련인 결과를 어떤 데이터에서만 볼 수 있다면 그 데이터는 잘 분류된 데이터임이 틀림 없다라는 생각이었습니다. 실제로 정규분포는 거의 어디에나 존재하는 자연의 법칙이 되었습니다.
6. 이항분포를 되살리려는 시도들
1876년에 렉시스는 확률 모형을 통해 시간에 따른 계열 데이터를 다루려고 시도해 보았습니다. 그는 각 계열 데이터를 이항분포의 표본추출 모형으로 보고 실제 데이터와 이항분포에서 계산된 오차를 비교하여 안정적인 계열을 식별하려고 했습니다. 그러나 이러한 사회적인 문제들은 독립성이 보장되지 않고 비선형적이거나 복잡하기에 이를 모두 반영하는 데 한계가 있었습니다.
그럼에도 불구하고 이러한 렉시스의 연구는 확률에 대한 초기의 단순한 항아리 모형이 근대적인 통계분석의 요구를 뒷밤침하기에 부족했다는 것을 소극적으로 증명한것 이라고 합니다.
7. 특출한 사회과학: 정신물리학
사회과학에서 불확정성을 계량화하는 데 대한 저항은 새로운 아이디어에 대한 일반적인 저항과 측정 자체에 대한 특별한 저항으로 볼 수 있습니다. 통계학은 이러한 저항을 극복하며, 심리학과 같이 어떤 분야가 새로이 탄생하는 데 힘을 보태는 역할도 했다고 합니다.
심리학에서는 개인들의 반응 차이를 분석하는데 관심을 가져 이러한 ‘개인 오차’를 통계적 방법으로 해결하려했습니다. 이는 애초에 천문학에서 연구되었던 주제로 관측자마다 차이가 있는 데이터들의 오차를 다루는 문제에서 시작되었습니다. 그러나 점차 관측 기구가 발달하면서 천문학에서는 크게 중요한 문제가 아니게되고 실험심리학에서 다루게 되었습니다.
통계적 방법론의 핵심이 되는 것들이 위 처럼 천문학에서 심리학으로 옮겨 가는 과정은 에빙하우스와 함께 완성이 되었습니다. 그는 데이터들이 외부의 통제되지 않은 원인들의 영향으로부터 분석이 가능할만큼 충분히 멀리 떨어져있다고 보증할 수 있는 명쾌한 논증을 발달시켰고, 데이터의 분포가 정규분포를 따른다는 중심극한정리의 역은 필연적으로 그 데이터가 분석에 적합하도록 전체가 동질적인 하나의 집단에서 나왔다는 것을 뜻한다는 믿음에 두었습니다.
위를 통해 실험심리학에서 통계학적 분석이 필수적인 방법론으로 자리 잡게 되었습니다. 이런 실험심리학에서 페히너가 ‘정답-오답 방법’을 통해 실험을 반복하여 정확도를 확률적으로 추정하였고, 실험계획법을 발전시켜 여러 요인들의 통제를 통해 불확실성을 줄였습니다. 이렇게 심리학에서 통계적인 방법이 쉽게 수용되었던 것은 어느 정도 실험계획을 통해 통제가 가능했기에 가능한 일이기도 합니다.
8. 영국에서의 혁신적인 발달: 골턴
골턴은 계량적 데이터가 정규분포를 따르는 정규곡선이 존재한다는 사실을 기반으로 재능의 유전성을 연구했지만, 재능의 세대에 따른 전달 방식과 이 곡선과 연결하지 못했었습니다.
만약 재능이 정규분포를 따른다면, 극단적인 재능은 자식에게 그대로 전달되기는 어려워보입니다. 그러나 골턴은 여기서 회귀라는 개념을 생각해내고 이를 이변량 정규분포와 결합함으로써 극복할 수 있었습니다. 이변량 정규분포를 통해 부모 세대에서의 부모의 극단적인 재능이 자식 세대에서의 자식은 평균으로 회귀하는 경향이 있음을 밝혀냈습니다.
이러한 개념을 직관적 설명하기 위해 과일의 크기에 영향을 미치는 요인들로 설명했습니다. 과일이 태양 빛에 노출되는 정도를 결정하는 “방향”(aspect)이 과일 크기에 미치는 영향처럼 “특별한 중요성”(extraordinary magnitude)을 갖는 영향을 생각해보면 분명 방향이라는 것은 과일의 크기를 결정하는 고정된 영향입니다. 이를 여러 강도로 나누어 생각해 생산된 과일을 한데 모아 섞어놓았을때, 전체 과일들이 정규분포를 따르는 이유는 무엇일까요?
이를 설명하기 위해 퀸컹크스를 활용하게 되는데, 칸을 과일의 서로 다른 방향이라고 정의하고 바닥의 칸들을 과일의 크기라 정의합니다. 여기서 좌우로 퍼지는 과정에서 개별적인 불규칙성을 가지는 기타 요인들이 결합하여 데이터가 정규분포를 따를 수 있음을 실증적으로 보여주었습니다. 다시 말해 여러 독립적인 요인들이 작용할때 그 영향들의 합은 정규분포를 이루는 경향을 이야기합니다. 즉, 부모의 재능이 극단적인 경우 자식의 재능은 부모의 영향과 함께 다양한 독립적 요인들의 영향을 받게 되고 이 요인들의 합은 결국 정규분포를 이루게 됩니다.
이후 골턴은 스위트피 실험을 통해 해당 원리를 검증했습니다. 스위트피 씨앗의 크기가 세대를 거듭해도 일정한 범위 내에서 유지되는 것은 단순한 우연이 안정성이 생기게 된 경우가 아니라, 정규분포라는 가정에서 안정성의 필연적으로 도출되는 결과였습니다. 이를 확장하여 골턴은 부모와 자식 간의 키의 관계에서 회귀 개념이 적용될 수 있음을 주장했으며, 나중에 이는 ‘상관관계’라는 개념으로 발전하게 되는 기초를 마련하였습니다.
9. 그 다음 세대: 에지워스
골턴의 연구는 보통 분포의 특성을 표현하며 계량적이지 않은 데이터를 양적인 척도의 데이터로 바꾸기 위해 통계적 척도(중위수, 백분위수)와 회귀 두 단계로만 생각했습니다. 에지워스는 오차의 전파라는 아이디어를 통해 상관계수에 대한 자신의 여러 추정량의 개연적 오차를 계산하는 복잡한 작업을 시도했습니다. 그는 다변량 정규분포 하에서 가장 가능성이 높은 값(기대치)는 여러 기관들의 평균을로 이루어진 벡터라는 사실을 밝혀냈는데, 이는 오늘날의 "랜덤 벡터의 기대치는 기대치들의 벡터"라는 표현으로 정리됩니다.
에지워스의 연구는 단순히 골턴의 회귀 개념을 재현한 데 그치지 않고, 사회과학 통계의 불확실성과 변동성을 다루는 새로운 방법론을 제시함으로써, 동질적이라고 보였던 집단 내부의 세분화된 차이를 검증하는 접근법의 토대를 마련한 중요한 업적으로 평가할 수 있습니다.
10. 피어슨과 율
피어슨은 회귀분석에서 적합도가 떨어지더라도 하나의 정규분포로 전체 집단에 대한 측저을 나타내야한다는 고집으로 극단적인 값들을 제외하려는 입장을 고수했습니다. 피어슨은 성장(이동평균) 때문에 비정규성이 생길 수도 있다고 인정했지만 극단적인 값들을 분석에서 제외하는 문제에서는 조금도 양보하지 않았습니다.
그러나 율은 회귀선이 직선이라고 여겨지기만 하면 어떤 경우에라도 그 분포가 정규분포인지를 따져볼 필요 없이 회귀 분석을 사용할 수 있다고 주장하며, 이를 정규분포의 속박에서 해방시키는 역할을 하였습니다. 회귀라는 방법은 더 이상 결합분포가정에 얽메인 방법이 아니게 되어 마침내 피상적이나마 본질적으로 최소제곱법이 줄곧 했던 역할, 즉 직선을 구하는 방법으로 여겨지게 되었습니다.
회귀와 최소제곱법 사이의 관계에서 얻은 결과 가운데 하나는 정규 방정식을 풀고 계수들의 개연적 오차 계산을 간단히 하기 위해 천문학자와 측지학자들이 만든 많은 계산식들을 활용할 수 있었다는 점이고 점차 두 변수씩 짝지어 상관계수를 써서 표현하는 법을 보여주기 시작했습니다. 이처럼 상관계수를 추정하는 문제가 회귀방정식을 추정하는 문제와 형식적으로 더 이상 분리 될 수 없는 문제가 되기는 했지만 실제적인 결과에서는 변한것이 없었습니다.
이렇게 불확실성을 측정하는 문제에서는 점진적인 발전이 이루어져 왔습니다. 측정 결과를 공식적으로 평가하고 비교할 수 있는 체계가 마련되었으며 과학을 계량화하는 논리를 완성하는 방향으로 나아갔습니다. 천문학과 측지학에서 이루어진초기의 성과들은 이후 사회과학에서의 발전과 유사한 면이 있었지만 개별적인 관측 결과들을 결합할 수 있는 개념적 구조가 부족한 장애물이 있었으나 최소제곱법과 확률이론이 결정적인 역할을 하여 해결할 수 있었습니다.
반면, 사회과학에서는 이론이 부족한 것이 아니라, 이론을 검증하는 데 사용되는 데이터가 지나치게 많은 변수를 포함하고 있어 문제를 단순화하기 어려웠습니다. 쿠르노는 다른 모든 요소를 고정한 상태에서 가격과 수요의 관계를 이론적으로 설명했지만, 현실에서는 모든변수를 고정할 수 없다는 한계가 있었습니다.
이러한 한계를 극복하기 위한 새로운 개념적 접근법이 유전학 연구에서 등장해 골턴, 에지워스, 피어슨이 통계적 구조를 구축해 나아갔고, 이후 율이 이들 간의 차이를 발견하고 사회과학의 문제를 정식화하여 분석할 수 있도록 하였습니다. 흥미롭게도, 이 과정에서 활용된 도구는 오래된최소제곱법으로, 르장드르의 것도 아니며 가우스나 라플라스의 최소제곱법과도 더더욱 다른 것 이었습니다.
유전에 대한 골턴의 연구에서 처음 등장한 회귀와 상관 개념이 19세기 초 최소제곱법과 밀접하게 연관되어 있다는 사실이 분명해지면서, 이는 통계학 역사에서 두 번째로 중요한 종합적 성취로 기록되었습니다. 다만, 여기서 확률이 수행한 역할은 오차 이론에서 와는 달랐습니다. 오차 이론에서는 중심극한정리를 통해 혼돈 속에서 질서를 발견하고 집합적인 관측값의 불확실성을 측정할 수 있도록 한 반면 사회과학에서는 원인의 다양성이 항상 존재하는 질서와 어떻게 조화를 이룰 수 있는지를 연구했습니다. 케틀레가 발견한 정규분포를 원인 분석이 가능하도록 해체할 수 있는 방법이 필요했습니다.
이에 관한 연구로 골턴은 ‘퀸컹크스’를 통해 조건부 확률의 새로운 기능을 제안하면서, 이러한 문제에 대한 해결책을 제시했습니다. 오차 이론에서는 조건부 확률 덕분에 천문학적 상수를 추론할 수 있었으며 회귀 분석에서도 조건부 확률을 활용하여 통계학자가 관심을 가지는 변수를 정의할 수 있게 되었습니다.
이처럼 확률이론은 우연의 개념에서 출발하여 점차 체계적인 학문으로 발전했으며 최소제곱법은 회귀 분석으로 확장되었습니다. 이는 뉴턴과 다윈이 과학에 끼진 영향 못지않은 중요한 변화를 가져왔습니다.
Ⅱ. 확률에 대한 철학적 시론
우리는 보통 통계와 확률을 같다고 생각하지만 사실 통계와 확률에는 생각의 시작점 부터가 매우 다릅니다. 통계는 데이터에서 결과를 도출하는 귀납적 사고이지만, 확률은 이론적 모델을 설정해 논리적으로 결론을 도출하는 연역적인 사고 방식입니다. 따라서, 통계 검정이라 불리우는 이유도 기존의 이론을 시험하는 방식이고, 확률적 가설 검정도 증명이 아니라 반증의 과정입니다.
2장 확률에 대해
확률은 충분한 이유의 원리로 현재와 과거의 시간을 잇는 중요한 학문입니다. 필연성은 우연성으로 격하된 것으로 규칙성은 동일한데 결정론과 확률의 차이가 있다면 무지에서 비롯된다는 것입니다.
4장 기댓값에 대해
보통 해당 학문을 경험하면 Expectation, Mean, Average를 많이 보게 되는데, 해당 단어들을 언제 사용하는 지 구분해보겠습니다.
기댓값(Expectation)은 랜덤 변수 상황 시 최고로 기대되는 숫자이고, Mean은 주어진 샘플에 따라 변화함. 여기서 Mean은 여러 가지가 존재하는데 그 중 Average는 산술 평균(Arithmetic Mean)을 의미해 일상 대화에서 많이 쓰고, Mean은 수학자나 통계학자들이 주로 쓴다고 합니다.
5장 확률론에서의 해석학적 방법에 대해
확률론에서 물리적 빈도와 같은 객관적 사실을 기반으로 하면 객관적 확률, 관찰자의 불완전한 정보와 신념을 기반으로 한것을 주관적 확률로 확률론은 우리의 무지를 정량화하는 도구입니다.
7장 같다고 가정한 확률들 사이에 있을 수 있는 미지의 상이함에 대해
우리가 모르는 미지의 편향이 존재한다면 그 편향의 방향을 무차별적인 방법(랜덤성)을 통해 방향을 바꾸면 된다고 합니다. 이는 횟수가 거듭될 수록 편향의 비중이 줄어들 것입니다.
8장 사건의 무한 반복으로부터 생기는 확률 법칙에 대해
두 항아리에 비율이 다르게 검은공과 흰공이 있으며 새 항아리에 해당 공들을 넣고 되돌리는 작업을 반복하게 되면 무질서 속에서 규칙적인 운동 패턴이 나타나 혼돈의 한복판에서 경탄할만한 법칙의 지배를 받는 시스템을 따르게 됩니다.
이는 가장 우연에 따르는 듯 보이는 현상들도 반복되면 항상 고정된 비에 가까이 되고, 각 비들이 충분히 작은 구간 속에 포함된다고 상상하면 관측한 것들의 평균이 이 구간안에 들어갈 확률과 확률성의 차이는 어떠한 값 보다 작아질 것이라고 합니다.
11장 증언의 확률에 대해
자연 법칙이 항상 변하지 않을 확률은 관심 대상인 어떤 사건이 실제로 일어나지 않았을 확률보다 크다는 결론을 내립니다. 자연 법칙이 항상 변하지 않을 확률을 반박하기에는 수 많은 반박의 근거들이 필요하게 됩니다. 왜냐하면 사람이 실수를 했을 가능성이 더 높다는 것을 의미하기 떄문입니다. 그런데 식견이 있는 사람한테는 믿음을 줄이는 역할을 해 괴이한 것을 붙잡으려는 오합지졸한테는 믿음을 높여주는 역할을 하게 됩니다. 여기서 증인이 많아질 수록 거짓말일 확률이 줄어듦을 보여줍니다.
16장 확률 추정에서의 착각에 대해
동전 던지기와 같은 도박에서 이전에 4번 연속으로 앞면이 나왔다고 해서 5번째에 뒷면이 나온다는 착각을 가지면 안됩니다. 여기에 특별한 이유가 있어 영향을 미치는 것이 아니라면 앞전의 일이 그 이후의 일에 영향을 미치지 않기 때문(독립성)입니다.
도박과 마찬가지로 복권 또한 이전에 많이 나온 번호가 그 뒤에 높은 확률로 나올 가능성은 없습니다. 복권당첨자가 나오지 않는다고 해서 다음에 더 높은 확률로 나오리란 보장도 없지만 ‘다음에는 나오겠지’라는 착각에 빠져 사람들이 복권을 사러 몰리게 되는데, 확률론은 이러한 첫 인상에 의한 착각(직관)에 빠지지 않게 해줍니다. 특히, 방법의 엄밀성 때문에 특별히 구별되는 수학에서 그러한 논증을 사용하는 것이 얼마나 위험한지를 보여주는 증거입니다.
17장 확실성에 가까워지기 위한 여러 가지 방법에 대해
귀납, 유추, 사실에 근거를 두고 세운 다음 새로운 관측에 의해 계속 수정되는 가설, 태어날 때 갖게 된 후 경험과의 많은 비교를 통해 강화되는 행운의 영감, 이런 것들이 진리에 이르는 주요 수단입니다. 계속 주의 깊게 살펴보다 보면 대상들 사이에서 또는 그들의 변화에서 유사성이 보이기 시작하고 대상이 늘어나면서 점점더 분명해지고 이것을 확장시키고 일반화시켜가면 종국에는 그 유사성이 나오게 된 원리를 알 수 있습니다. 하지만 이러한 유사성은 종종 아주 많은 외적인 환경속에 가려져있기때문에 이 유사성을 찾아내고 그 원리까지 밝혀내려면 대단히 예민해야합니다.
과학의 진수는 바로 여기에 있으며 해석학과 자연과학이 밝혀낸 가장 중요한 것들은 귀납이라고 불리는 풍성한 벙법 덕분입니다. 귀납으로 얻은 결과의 확률을 추정하기란 어려운 일로 귀납의 바탕은 가장 단순한 관계가 가장 일반적이라는 것입니다. 귀납은 부정확한 결과가 나오기도 하기 때문에 항상 증명이나 결정적인 실험을 통해 확증할 필요가 있습니다.
개인적으로 근래 크게 대두되고 있는 LLM도 이처럼 귀납을 통해 나온 결과이며 정확히는 결과의 확률을 부여하여 확률적론적 추론을 진행하는 것이라 생각합니다.
유추(analogy)는 유사한것들이 같은 종류의 원인 떄문에 생겨서 같은 결과를 낳을 확률에 바탕을 두고 있으며 유사성이 완전할수록 이 확률도 커집니다. 일례로 식물에 비해 동물과 같이 인간과 비슷한 신체구조가 있으면 우리와 유사한 경험을 겪을 것이라고 유추할 수 있으며 화성에 물이 있어 우리와 비슷한 생명체가 있을 거라는 생각은 너무 비약적인 유추일 수 있습니다.
많은 과학적 발견은 이러한 유추에 의해 이루어 지게 되며 전기와 천둥사이의 관계인 ‘대기전기’처럼 항상 느리고 힘든 귀납이라는 과정을 따랐던 것만은 아닙니다. 원인을 무척 캐고 싶어하는 사람들은 상상력을 발휘하여 가설을 즐겨 만들고 자신의 목적에 맞게 사실을 왜곡해 이런 경우의 가설은 위험할 수 있습니다.
계산으로 다양한 수단을 써서 얻은 결과의 확률을 다루기는 거의 항상 불가능한데, 역사적 사실의 경우에도 마찬가지 입니다. 하지만 때로 확률을 추정할 수 없다면, 설명되는 현상들의 총체, 또는 증거들의 총체에 대해 이성적으로 어떤 의심도 가질 수 없습니다. 그렇지 않은 경우라면 단지 지극히 세심하게 그 현상과 증거들을 대하는 것이 현명하다고 합니다
18장 덧붙이는 글: 확률론의 역사에 대해
17세기에 발견된 확률론의 주요 문제는 '도박을 하다가 중간에 중단 시, 판돈을 어떻게 분배하는 것이 공평한가'에 대한 문제였습니다. 각 참가자가 이길 확류에 비례해서 판돈을 분배하는 것은 분명하지만 파스칼과 페르마 이전에는 아무도 이 주제에 수학을 적용하기 위한 원리와 방법을 연구하지 않았고, 복잡한 문제를 해결하지 못했습니다.
이러한 수학적 기댓값과 정신적 기댓값의 구별, 그리고 정신적 기댓값을 분석하기 위해 다니엘 베르누이가 만든 독창적인 원리가 있었습니다.
보통 법원의 판결은 확률 이론의 지배를 받는데, 이런 일들에서 생기는 문제들은 대단히 많은 감정과 다양한 이해관계의 상황들로 인해 매우 복잡해지기 떄문에 거의 항상 해결이 불가능합니다. 하지만 문제들과 아주 유사한 보다 단순한 문제를 풀면 어렵고 중요한 문제를 푸는 실마리가 나올 수도 있으며 확률을 이용한 방법이 다른 추론 과정보다 수학이 갖는 확실성 덕분에 늘 가장 선호할만 합니다.
확률 이론을 활용하는 경우들 가장 흥미로운 것은 관측 결과들 가운데에서 평균 값을 선택해야 할 경우 입니다. 이 문제는 여러 수학자들이 연구한 바 있는데, 라그랑주는 관측에서 생기는 오차의 법칙을 알고 있을때 평균을 구하는 멋진 방법을 ‘토리노 논문집’에서 발표한 바 있습니다.
가우스가 조건 방정식의 우변을 제곱하여 모두 합한 다음, 거기에 들어있는 미지의 모수를 변수로 간주하고 그합을 최소로 만드는 ‘최소제곱법’을 생각해냈습니다. 이렇게 하면 미지의 수만큼 최정방정식을 얻게 되는데, ‘이 값들이 다른 방법으로 구한 값보다 더 낫다고 할 수 있는가?’라는 질문에 확률론으로 밖에 답할 수 없습니다.
하지만 결과에 따라올 수 있는 오차의 법칙을 알지 못하는 한 그 결과에 대해 우리가 알고있는 것은 불완전할 수 밖에 없습니다. 여기서 우리는 오차가 어떤 정해진 한계 안에 있을 확률을 구할 수 있어야 하는데, 이는 앞에서 비중이라고 부르는 것을 정하는 것에 해당합니다. 해석학으로부터 이를 위한 일반적이면서도 간단한 식을 얻을 수 있었고, 그 결과를 측지학 관측결과에 적용하였습니다.
관측이 엄청 많지는 않다면, 상수 값들 주변에 남아 있는 작은 불확실성은 분석 결과로 정해지는 확률이 약간 불확실해지는 원인이 됩니다. 하지만 관측 결과에 있는 오차의 확률이 좁은 한계 안에 들어갈 확률이 1에 가까운지 아는 것으로도 충분합니다. 만일 그렇지 못하다면, 그 결과의 질적인 특성에 대해서 상당할 정도로 의심이 남지 않을 확률을 얻으려면 관측이 얼마나 더 필요한지만 알아도 충분해서 확률에 대한 해석학적인 식들을 이용하면 그렇게 할 수 있게 됩니다.
현상의 규칙적인 원인은 대부분 알려지지 않았거나 수학으로 다루기에는 너무나 복잡합니다. 종종 그원인들의 작용은 우연하거나 외부적인 원인들 때문에 간섭을 받지만 원인들의 작용은 원인들이 만든 사건에 반드시 흔적을 남기므로 오래 관측해보면 그러한 작용의 결과로 생긴 변형을 찾아낼 수 있습니다. 확률 해석학은 이러한 변형을 설명해주고, 또한 원인들의 확률을 정하고, 그 확률을 점점 높이는 방법도 알려줍니다.
이처럼 게임을 다루면서 시작된 학문이 인간의 지식 가운데에서 가장 중요한 지위로 올라서는 것은 주목할 일입니다. 덕분에 전혀 독단적이지 않게 의견을 선택하고 나아갈 방향을 정할 수 있으며 늘 가장 유리한 선택을 할 수 있습니다. 이 이론은 무지와 인간 정신의 허약함에 대한 가장 적절한 보완물이 됩니다. 이 이론에서 나오는 해석학적 방법, 기초가 되는 참된 원리들, 문제해결을 위해 필요한 나카롭고 세밀한 논리, 이 이론 덕분에 생기는 공공의 복리, 자연과학과 인간과학에서 생기는 가장 중요한 문제에 대해 적용되면서 확대되었고 지금도 확대되고 있으며 수학을 적용 할 수 없는 것에 대해서까지도 판단할 수 있는 가장 확실한 지침을 제공하며 때로는 혼란시키는 착각을 피할 수 있게 해준다는 것을 생각해보면 더 가치있는 학문이 없음을 알게 될 것입니다.
저자는 해당 도서를 통해 확률 이론이란 근본적으로 상식을 수학화한 것 일 따름(“The theory of probabilites is basically only common sense reduced to a calculus”)임을 알게 되었다고 합니다. 해당 주장은 책 맨앞에 나오는 결정론을 옹호하는 부분으로 엄청난 데이터를 처리 할 수있는 지적인 능력을 가진 존재가 있다면 모든것을 간단한 법칙으로 나타낼 수 있을 것이라는 주장과 더불어 이 책 전체에서 가장 유명하고 자주인용되는 부분이라고 옮긴이 주석으로 나와있습니다.
Ⅲ. 통계학을 떠받치는 일곱가지 기둥이야기
1 자료 집계(Aggregation)
19세기에는 ‘관측의 결합’이라고 불리웠으며 ‘평균 인간’이라는 것을 시도했지만 관련이 없는 것을 모아 놓아 평균을 아무 것도 아닌 것이 나오게 됨. 생물학이나 의학에서 개별성을 지니는 개체들이 이종요소를 써서 일반 초상화를 합성하려 해서는 안된다고 골턴이 말함.
평균, 최빈값, 중앙값 등을 소개했는데 평균에 관한 종류는 10가지나 되어 산술평균을 기준으로 설명함. 이러한 자료 집계는 개별 관측 하나하나를 모두 열거하는 대신 요약을 사용하고 정보를 선택적으로 버림으로써 정보를 얻으려 하는 기본원리는 마찬가지라고 하였습니다.
즉, 본질에서 정보를 버리는 ‘창조적 파괴’ 활동을 포함합니다. 여기서 개별성을 가린다고 비난할 수는 있지만 이런 관계의 균형을 맞추는 일이 통계작업의 지혜를 뒷받침하는데 필요합니다.
2 정보 측정: 정보 측정과 변화율
통계학에서는 정보 축적의 역설로 ‘모든 측정값이 똑같이 정확하더라도 뒤에 잰 측정 값 10개가 먼저 잰 10개보다 덜 가치가 있다.’는 말이 존재합니다. 즉, 똑같아 보이는 정보 덩어리가 통계분석에서는 다른 가치를 지닌다는 이야기입니다. 이는 통계학과 과학에서 정보라는 용어를 달리 사용하거나 잘못 사용할때 두드러진다고 합니다.
통계 이론에서 피셔 정보가 있습니다. 모수 추정 문제에서 피셔 정보 \(I(\theta)\)는 점수 함수를 제곱한 값의 기댓값이고, 자료에 대한 확률 밀도함수의 로그 도함수로 정의됩니다. 확률이 \(\theta\)에 민감할 수록 자료는 더 많은 정보를 유추하게 됩니다. 피셔 정보의 단위 크기는 제곱으로 가산 측도(additive)이므로 자료 구간의 길이가 같으면 정보량도 같습니다.
정보 축적을 통계적으로 평가하는 일은 매우 복잡할 수 있습니다. 그러나 다른 자료 집학과의 비교나 증가에 따른 정보의 증가율 등 자료에 담긴 정보를 측정하는 일은 매우 중요한 일입니다.
3 가능도: 확률 척도의 보정
주화 검정의 일례로 금의 무게를 N, 하나의 오차의 무게를 P로 잡았을때 100개를 한꺼번에 검정할 때 예전에는 100N과 100P라는 무게로 느슨하게(?) 검정을 진행했었습니다. 그러나 이는 주화 무게가 독립일 시 표본 개수의 제곱근만큼 변동이 증가한다는 방법으로 주화 100개를 한번에 검정할때 오차는 10P라는 값이 나와야 합니다.
likelihood(가능도; 우도)는 특별할 우 와 정도 도 로 특정한 값(모수)에 대한 특별한 정도로 어떤 데이터가 특정한 모수로부터 나왔을 정도를 의미합니다. 이는 확률분포의 관점에서 주어진 데이터가 특정한 모수에서 나왔을 가능성을 측정하는 값 입니다.
이처럼 추론을 보정하고 불확실성을 측정할 척도를 제공하고자 사용하는 확률을 이용해 추론을 바로 잡는 방법을 소개했습니다. 보편적으로 유의성 검정과 p-value 등에서 나타납니다.
4 상호 비교: 표본 내 변동을 표준으로
통계적 비교를 외부 표준에 준거하지 않고 자료 내부 측면에서 보는 방법입니다.
두 표본의 비교로 스튜던트 t-검정에서 시작하여 분산분석법으로 발전된 방법론으로 표본간 비교에 있어 개별 표본 내 변동의 크기가 확률적 가능자의 역할을 합니다.
이는 양날의 검으로 외부 표준에 기대지 않기에 모든 문제에서는 영향력이 없을 수 있습니다.
5 회귀: 다변량 분석, 베이즈 추론, 인과 관계 추론
회귀현상은 간단하게 설명해서, 상관이 완전하지 않은 측정값 두 개 가운데 자체 평균에서 벗어난 하나를 고르면 남은 하나는 표준 편차 단위로 됐을 때 덜 벗어날 것이라는 현상입니다.
‘평균적으로 키가 큰 부모는 부모보다 키가 더 작은 자식을 낳는다. 평균적으로 키가 큰 자식은 키가 더 작은 부모를 가진다.”와 같은 회귀의 열설인 동시에 베이즈 추론과 인과 추론의 기본이 됩니다.
해당 방법은 여러 관점에서 한 질문을 한다는 발상은 기대하지 않은 통찰을 낳을 뿐만 아니라 분석의 틀을 잡는 새 방법을 알려주었습니다.
6 설계: 실험 계획과 랜덤화의 역할
실험계획은 균일한 관측 환경에서 사고를 훈련할 수 있는 이상적인 개념으로 피어스와 피셔가 랜덤화를 통해 추론에서 맡을 수 있는 놀라운 역할을 찾아냄으로 시작되었습니다. 이를 통해 효과를 분리하고 교호작용을 추정할 수 있었으며 정규성을 가정하거나 물질의 균질성을 가정하지 않고도 타당하게 추론 할 수 있었습니다.
7 잔차: 과학 논리, 모형 비교, 진단 표시
잔차는 고차원을 탐구하는 지표가 됩니다.
Ⅳ. 마치며
최근 발견한 오래된 테드 강연(April 2016, “Why you should love statistics”, Alan Smith at TEDxExeter)과 최근 알게된 어구를 소개로 마무리 하겠습니다.
“we can be blind to the obvious, and we are also blind to our blindness”
- Daniel Kahneman
세상을 숫자를 잘 다루는 사람과 못 다루는 사람으로 이분법적인 사고로 생각할 수는 없다고 합니다. 강연자가 진행한 실험에서 저명한 통계학자는 자기 지역에 대해 44% 밖에 못 맞추었다고 합니다.
즉, 아무리 숫자와 친하더라도 사람들은 통찰력 있게 보지 못하므로 숫자를 통해 보아야 한다고 합니다.
보통 사람들은 직관에 의존하는 경향이 있어 실제 데이터와 인식 사이에 큰 괴리가 발생함을 강조해 통계학이 우리의 세계를 더 정확하게 이해하는데 필수적이며 우리 자신에 대한 과학이라고 주장했습니다.
소년이노학난성(소년은 늙기 쉬우나 학문을 이루기는 어렵다) - 주자 주문공문집 중
아는 만큼 보이며 배우고 익힐수록 더 넓은 세상을 보아 학문을 이루기 어려워 한다는 의미입니다.
추가로 “i sensed anxiety and frustration at NeurIPS’24” 해당 글이 많은 샤라웃을 받았다고 해서 한번 읽어보았습니다.
딥러닝의 급성장으로 AI 연구자와 엔지니어에 대한 수요가 폭증하면서 경쟁이 심화되었고, 기업들은 미래를 대비해 박사급 인력을 대량 채용했습니다. 덕분에 박사들은 원하는 연구를 수행할 수 있었지만, 이로 인해 박사 지원자가 급증했고, 이는 지속 가능하지 않게 되었습니다.
AI 연구의 상품화(commercialization)가 진행되면서 연구자들은 제품 개발과 수익 창출에 직접 기여할 것을 요구받고 있습니다. 연구팀은 제품팀보다 상대적으로 자원이 적고, 기업 내에서도 실용적이고 효율적인 모델을 학습, 테스트, 배포하는 학·석사 출신들이 더 능숙하다고 평가받고 있습니다.
이로 인해 AI 인재 파이프라인이 급격히 변화하고 있으며, 박사급 연구자들의 역할이 줄어들고 있습니다. 특히 박사 과정의 말기에 있는 학생들은 과거에 약속된 연구 환경과 현재 산업의 현실 사이에서 격차를 느끼며 무력감을 경험하고 있습니다. NeurIPS 2024에서 이러한 분위기가 감지되었으나, 저자는 이를 완화할 방법을 찾지 못했다고 합니다.
이전에는 대학원에 진학할 생각이 존재했으나 점차 AI와 관련된 교육이 체계화되고 배우고 되는 시기도 빨라지게 되면서 그 기준이 점차 내려가는 것이 눈에 보이기 시작했습니다. 물론 대학원에 나가서 ‘연구’ 라는 경험을 하는 것이 중요하기도 하지만 내가 진정으로 추구하는 것이 ‘연구’가 아닌 ‘발전’이기에 현재에 집중하게 되었습니다.