[Paper]Diffusion
해당 논문은 시간에 따라 변화하는 비평형 통계적 물리학에서 영감을 받아 시작된 디퓨전 절차로 현재 많은 생성형 모델에 사용되고 있습니다. 해당 절차를 간단히 소개하면 반복적인 forward diffusion 절차를 통해 데이터 분포를 천천히 시스템적으로 구조를 파괴하고 나서 reverse diffusion 절차를 통해 데이터의 구조를 회복하는 과정입니다.
Ⅰ. Diffusion probabilistic models
역사적으로 확률 모델은 “tractability”와 “flexibility” 사이의 trade-off 관계로 문제를 겪어왔었습니다. tractable 모델은 분석적으로 평가하고 쉽게 데이터를 적용할 수 있지만 풍부한 데이터셋을 적절하게 묘사하지 못합니다. 반면에 flexible한 모델은 풍부한 데이터에서 구조에 적합하게 모델링 될 수 있지만 전형적으로 매우 비싼 몬테 카를로 절차가 필요합니다.
모델의 구조적 유연성정확한 샘플링다른 분포와의 쉬운 곱셈로그 우도 및 개별 상태의 확률의 쉬운 평가
따라서, 위의 성격을 가지는 모델을 해당 논문에서 소개합니다. 마코브 체인을 활용하여 다른 분포로 점진적으로 변환하는 아이디어로 비평형 통계적 물리학과 순차적 몬테카를로에서 시작되었다고 합니다.
우선, 생성형 마코브 체인을 만들어 단순히 알려진 분포에서 목표 분포로 디퓨전 절차를 사용하여 변환합니다. 그리고 확률 모델을 마코브 체인의 end-point로 설정하면, 디퓨전 체인의 각 단계에서 확률을 정량적인 평가가 가능하기에 전체적인 과정이 정량적으로 평가되어 근사적으로 모델을 평가 할 수 있습니다.
해당 프레임워크를 학습하는 과정에서 디퓨전 절차를 통해 작은 변화를 추정하는 것이 포함됩니다. 작은 변화를 추정하는 것은 전체 분포를 명시적으로 묘사하는 것보다 단순하며, 정량적으로 정규화할 수 없는 단일 잠재 함수를 또한, 디퓨전 절차가 연속적인 목표 분포를 위해 존재하기에 풍부한 형태의 데이터 분포를 수집할 수 있게 됩니다.
Ⅱ. Algorithm
해당 논문에서 제안한 생성형 모델 분포로 복잡한 데이터 분포를 단순하고, 다루기 쉬운 분포로 변환하고 디퓨전 절차의 역전 과정을 학습하는 것을 설명합니다.
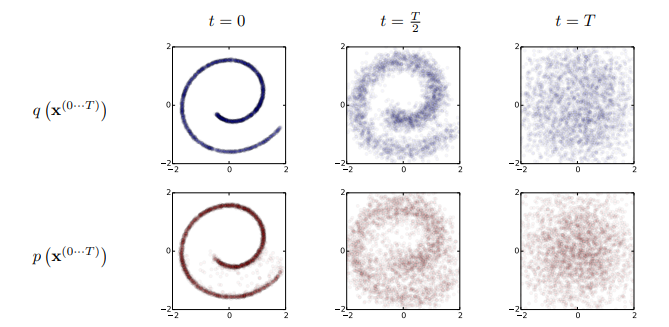 Figure 1 : Overview of Diffusion framework, 첫번째 행은 왼쪽에서 오른쪽으로 순방향 절차이고 두번째 행은 오른쪽에서 왼쪽으로 역방향 절차이다.
ⅰ. Forward Trajectory
데이터 분포(\(q(x^0)\))가 주어졌다고 하면, 데이터 분포는 점차적으로 목표하는 분포 \(\pi(y)\)로 반복적인 마코브 디퓨전 커널(\(T_\pi(y\vert y';\beta)\))을 적용하여 변환되게 됩니다. 여기서 \(\beta\)는 디퓨전 rate입니다.
\[\begin{align} \pi(y) &= \int dy'T_\pi(y \vert y'; \beta)\pi(y') \tag{1} \\ q(x^{(t)} \vert x^{(t-1)}) &= T_\pi(x^{(t)} \vert x^{(t-1)};\beta_t) \tag{2} \end{align}\]즉, 순방향 과정은 아래와 같이 데이터 분포에서 시작하여 T 단계의 디퓨전을 수행하게 됩니다.
\[q(x^{(0...T)}) = q(x^{(0)})\Pi^T_{t=1} q(x^{(t)} \vert x^{(t-1)}) \tag{3}\]보통 이미지에서 Forward diffusion 과정에서는 아래와 같이 단계별로 노이즈 데이터를 추가하여 사후확률(\(q(x^{(t)} \vert x^{(t-1)})\))분포를 생성합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
def generate_forward_diffusion_sample(self, X_noiseless):

    ...

    # 균일분포에서 노이즈를 생성하여 원본 이미지에 결합함.
    X_uniformnoise = X_noiseless + (rng.uniform(size=(n_images, self.n_colors, self.spatial_width, self.spatial_width),
        dtype=theano.config.floatX)-T.constant(0.5,dtype=theano.config.floatX)*T.constant(self.uniform_noise,dtype=theano.config.floatX)

    # alpha_cum_forward의 가중치로 이미지에 노이즈를 추가함.
    X_noisy = X_uniformnoise*T.sqrt(alpha_cum_forward) + N*T.sqrt(1. - alpha_cum_forward)

    ...

    # 사후확률 분포의 평균과 표준편차를 계산하여 반환함.
    return X_noisy, t, mu, sigma
\[\begin{align} p(x^{(T)}) &= \pi(x^{(T)}) \tag{4} \\ p(x^{(0...T)}) &= p(x^{(T)})\Pi^T_{t=1}p(x^{(t-1)}\vert x^{(t)}) \tag{5} \end{align}\]ⅱ. Reverse Trajectory
디퓨전 절차의 역과정은 전방향 과정과 동일한 형태로 진행됩니다. 아래와 같이 노이즈가 추가된 이미지에서 사후확률 분포의 평균과 표준편차를 계산합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
def get_mu_sigma(self, X_noisy, t):

    # MLP를 통해 노이즈가 추가된 이미지의 잠재 벡터 Z를 구함
    Z = self.mlp.apply(X_noisy)

    # 추출된 특징 벡터를 바탕으로 각 픽셀에 대한 평균과 분산의 계수를 계산함.
    mu_coeff, beta_coeff = self.temporal_readout(Z, t)

    # forward diffusion에서 t step의 공분산 reverse variance is perturbation around forward variance
    beta_forward = self.get_beta_forward(t)

    # 정규화 상수의 비율을 통해 전이 확률을 보정함.
    beta_coeff_scaled = beta_coeff / np.sqrt(self.trajectory_length).astype(theano.config.floatX)
    beta_reverse = T.nnet.sigmoid(beta_coeff_scaled + util.logit(beta_forward))

    # 사후확률 분포를 계산하여 반환함.
    mu = X_noisy*T.sqrt(1. - beta_forward) + mu_coeff*T.sqrt(beta_forward)
    sigma = T.sqrt(beta_reverse)

    return mu, sigma
\[p(x^{(0)}) = \int dx^{(1...T)}p(x^{(0...T)}) \tag{6}\]ⅲ. Model probability
위와 같은 적분은 단순히 계산하기 여러우나 샘플링을 통해 강화된 신호를 받으면 “Jarzynski equality”를 사용할 수 있습니다. 따라서, 순방향 및 역방향 궤적의 관련된 확률을 평가할 때 평균화함으로써, 순방향 절차에서 평균적인 오버샘플링을 통해 빠르게 평가할 수 있습니다.
\[\begin{align} p(x^{(0)}) &= \int dx^{(0...T)}p(x^{(0...T)})\frac{q(x^{(1...T)} \vert x^{(0)})}{q(x^{(1...T)} \vert x^{(0)})} \tag{7} \\ &= \int dx^{(0...T)}q(x^{(1...T)}\vert x^{(0)})\frac{p(x^{(0...T)})}{q(x^{(1...T)} \vert x^{(0)})} \tag{} \\ &= \int dx^{(0...T)}q(x^{(1...T)}\vert x^{(0)})p(x^{(T)})\Pi^T_{t=1}\frac{p(x^{(t-1)} \vert x^{(t)})}{q(x^{(t)} \vert x^{(t-1)})} \tag{} \end{align}\]ⅳ. Training
학습은 아래와 같은 로그 우도를 최대화하는 목표로 진행됩니다.
\[\begin{align} L &= \int dx^{(0)}q(x^{(0)})logp(x^{(0)}) \tag{8} \\ &= \int dx^{(0)}q(x^{(0)})log[\int dx^{(1...T)}q(^{(1...T)}\vert x^{(0)}) \cdot p(x^{(T)})\Pi^T_{t=1}\frac{p(x^{(t-1)} \vert x^{(t)})}{q(x^{(t)} \vert x^{(t-1)})}] \tag{} \end{align}\]Jensens inequality를 통해 아래와 같은 하한을 가지게 됩니다.
\[\begin{align} L &\leq \int dx^{(0...T)}q(x^{(0...T)}) \cdot log[p(x^{(T)})\Pi^T\frac{p(x^{(t-1)} \vert x^{(t)})}{q(x^{(t)} \vert x^{(t-1)})}] \tag{9} \\ &= K \tag{} \end{align}\]또한, K는 아래와 같은 엔트로피와 KL divergence로 표현이 가능합니다.
\[\begin{align} K &= - \sum_{t=2}^{T} \int dx^{(0)}dx^{(t)} q(x^{(0)}, x^{(t)}) \tag{10}\\ &\space \cdot D_{KL} \left[ q \left( x^{(t-1)}|x^{(t)}, x^{(0)} \right) || p \left( x^{(t-1)}|x^{(t)} \right) \right] \tag{}\\ &\space + H_q \left( x^{(t)}|x^{(0)} \right) - H_q \left( X^{(1)}|x^{(0)} \right) - H_p(X^{(T)}) \tag{} \end{align}\]이를 통해 K는 계산이 가능해 확률 분포 추정하는 작업은 회귀를 수행하는 태스크로 축소됩니다. forward diffusion 절차에서 노이즈 이미지를 생성하는 과정에서의 확률 분포와 reverse diffusion 절차에서 원본 이미지로 변환하는 과정에서의 확률 분포의 차이를 줄이는 형태로 아래와 같이 계산되게 됩니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
def get_negL_bound(self, mu, sigma, mu_posterior, sigma_posterior):

    # forward diffusion 확률 분포와 reverse 확률 분포의 KL divergence 계산 코드
    KL = (  T.log(sigma) - T.log(sigma_posterior)
            + (sigma_posterior**2 + (mu_posterior-mu)**2)/(2*sigma**2)
            - 0.5)

    # 조건부 엔트피 계산 코드
    H_startpoint = (0.5*(1 + np.log(2.*np.pi)).astype(theano.config.floatX) + 0.5*T.log(self.beta_arr[0])
    H_endpoint = (0.5*(1 + np.log(2.*np.pi)).astype(theano.config.floatX) + 0.5*T.log(self.get_beta_full_trajectory()
    H_prior = (0.5*(1 + np.log(2.*np.pi)).astype(theano.config.floatX) + 0.5*T.log(1.)

    # 로그 우도 하한 식
    negL_bound = KL*self.trajectory_length + H_startpoint - H_endpoint + H_prior

    # 가우시안 분포의 로그 우도 식
    negL_gauss = (0.5*(1 + np.log(2.*np.pi)).astype(theano.config.floatX) + 0.5*T.log(1.)

    # 로그 우도 차이 계산.
    negL_diff = negL_bound - negL_gauss

    # 로그 우도 비트 단위로 변환
    L_diff_bits = negL_diff / T.log(2.)
    L_diff_bits_avg = L_diff_bits.mean()*self.n_colors

    return L_diff_bits_avg
ⅴ. Multiplying Distributions, and computation posteriors
signal denoising이나 missing value의 추론을 위해 사후확률을 계산하는 작업은 모델의 분포를 두번째 분포로 곱하는 것으로 이루어집니다.
\[\tilde{p}(x) \propto p(x) \cdot r(x)\]그러나 분포를 곱하는 것은 계산량이 많고 어려운 작업입니다. 디퓨전 모델에서는 두번째 분포를 작은 변동으로 다루어 각 단계에서 곱해지게 됩니다.
\[\tilde{p}(x^{(t)}) = \frac{1}{\tilde{Z_t}}p(x^{(t)})r(x^{(t)})\]우선 \(\tilde{p}(\cdot)\)을 구하기 위해 각 중간의 분포를 \(r(\cdot)\)를 가지고 곱하게 되면 위와 같이 표현가능합니다. 여기서 \(Z_t\)는 정규화 상수이고, t번쨰 중간의 분포의 크기를 조정합니다.
따라서, 역방향 디퓨전 절차의 마코브 커널(\(p(x^{(t)} \vert x^{(t+1)})\))은 아래와 같이 됩니다.
\[p(x^{(t)}) = \int dx^{(t+1)}p(x^{(t)} \vert x^{(t+1)})p(x^{(t+1)})\]\(\tilde{p}(x^{(t)} \vert x^{(t+1)})\)이 위 식을 만족하면,
\[\begin{align} \tilde{p}(x^{(t)}) &= \int dx^{(t+1)}p(x^{(t)} \vert x^{(t+1)})\tilde{p}(x^{(t+1)}) \tag{11}\\ \frac{1}{\tilde{Z_t}}p(x^{(t)})r(x^{(t)}) &= \int dx^{(t+1)}p(x^{(t)} \vert x^{(t+1)})\cdot \frac{1}{\tilde{Z_{t+1}}}p(x^{(t+1)})r(x^{(t+1)}) \tag{} \\ p(x^{(t)}) &= \int dx^{(t+1)}p(x^{(t)} \vert x^{(t+1)})\cdot \frac{Z_{t}r(x^{(t+1)})}{\tilde{Z_{t+1}r(x^{(t)})}}p(x^{(t+1)}) \tag{} \end{align}\]위와 같이 전개가 되고, 다음과 같이 정의됩니다.
\[\begin{align} \tilde{p}(x^{(t)} | x^{(t+1)}) &= p(x^{(t)} | x^{(t+1)}) \frac{Z_{t+1}r(x^{(t)})}{\tilde{Z_{t}r(x^{(t+1)})}} \tag{12} \\ &= p(x^{(t)} | x^{(t+1)}) \frac{1}{\tilde{Z_{t}(x^{(t+1)})}} r(x^{(t)}) \tag{} \end{align}\]여기서 \(r(x^{(t)})\)이 충분히 연속적이라면 작은 변화로 다룰 수 있어 역방향 디퓨전 커널에 적용할 수 있습니다. 이 경우 \(\tilde{p}(x^{(t)} \vert x^{(t+1)})\)가 \(p(x^{(t)} \vert x^{(t+1)})\)와 동등한 형태를 가지게 됩니다. 전형적으로 \(r(x^{(t)})\)는 초기 값으로 설정합니다.
해당 내용은 위의 reverse diffusion code의 beta_coeff_scaled를 통해 계산이 됩니다.
Ⅲ. REFERENCES
- J. Sohi-Dickstein at el,”Deep Unsupervised Learning using Nonequilibrium Thermodynamics”, ICML 2015
- Diffusion-Probabilistic-Models github